






Benchmark analysis: Glean versus Claude Cowork across departmental work
` - A paragraph about lower cost per task - A figure - `The reason we delivered a 70% reduction in token usage is based on architectural decisions in Glean:
` The FR translation **stops at the heading** `Analyse comparative : Glean face à Claude Cowork pour les travaux par département
` and is **missing** the final paragraph, figure, and closing sentence. This is a significant omission. Here is the corrected French with the missing content appended:Chez Glean, nous sommes depuis longtemps convaincus que privilégier l'intelligence de manière isolée, sans tenir compte des coûts, est une mauvaise approche. Dans un paysage de modèles en constante évolution, courir après l'intelligence de pointe à elle seule est une démarche coûteuse. Il est bien plus important de comprendre les compromis que chaque modèle établit entre coût et performance, et d'utiliser cette compréhension pour confier la bonne intelligence à la bonne tâche.
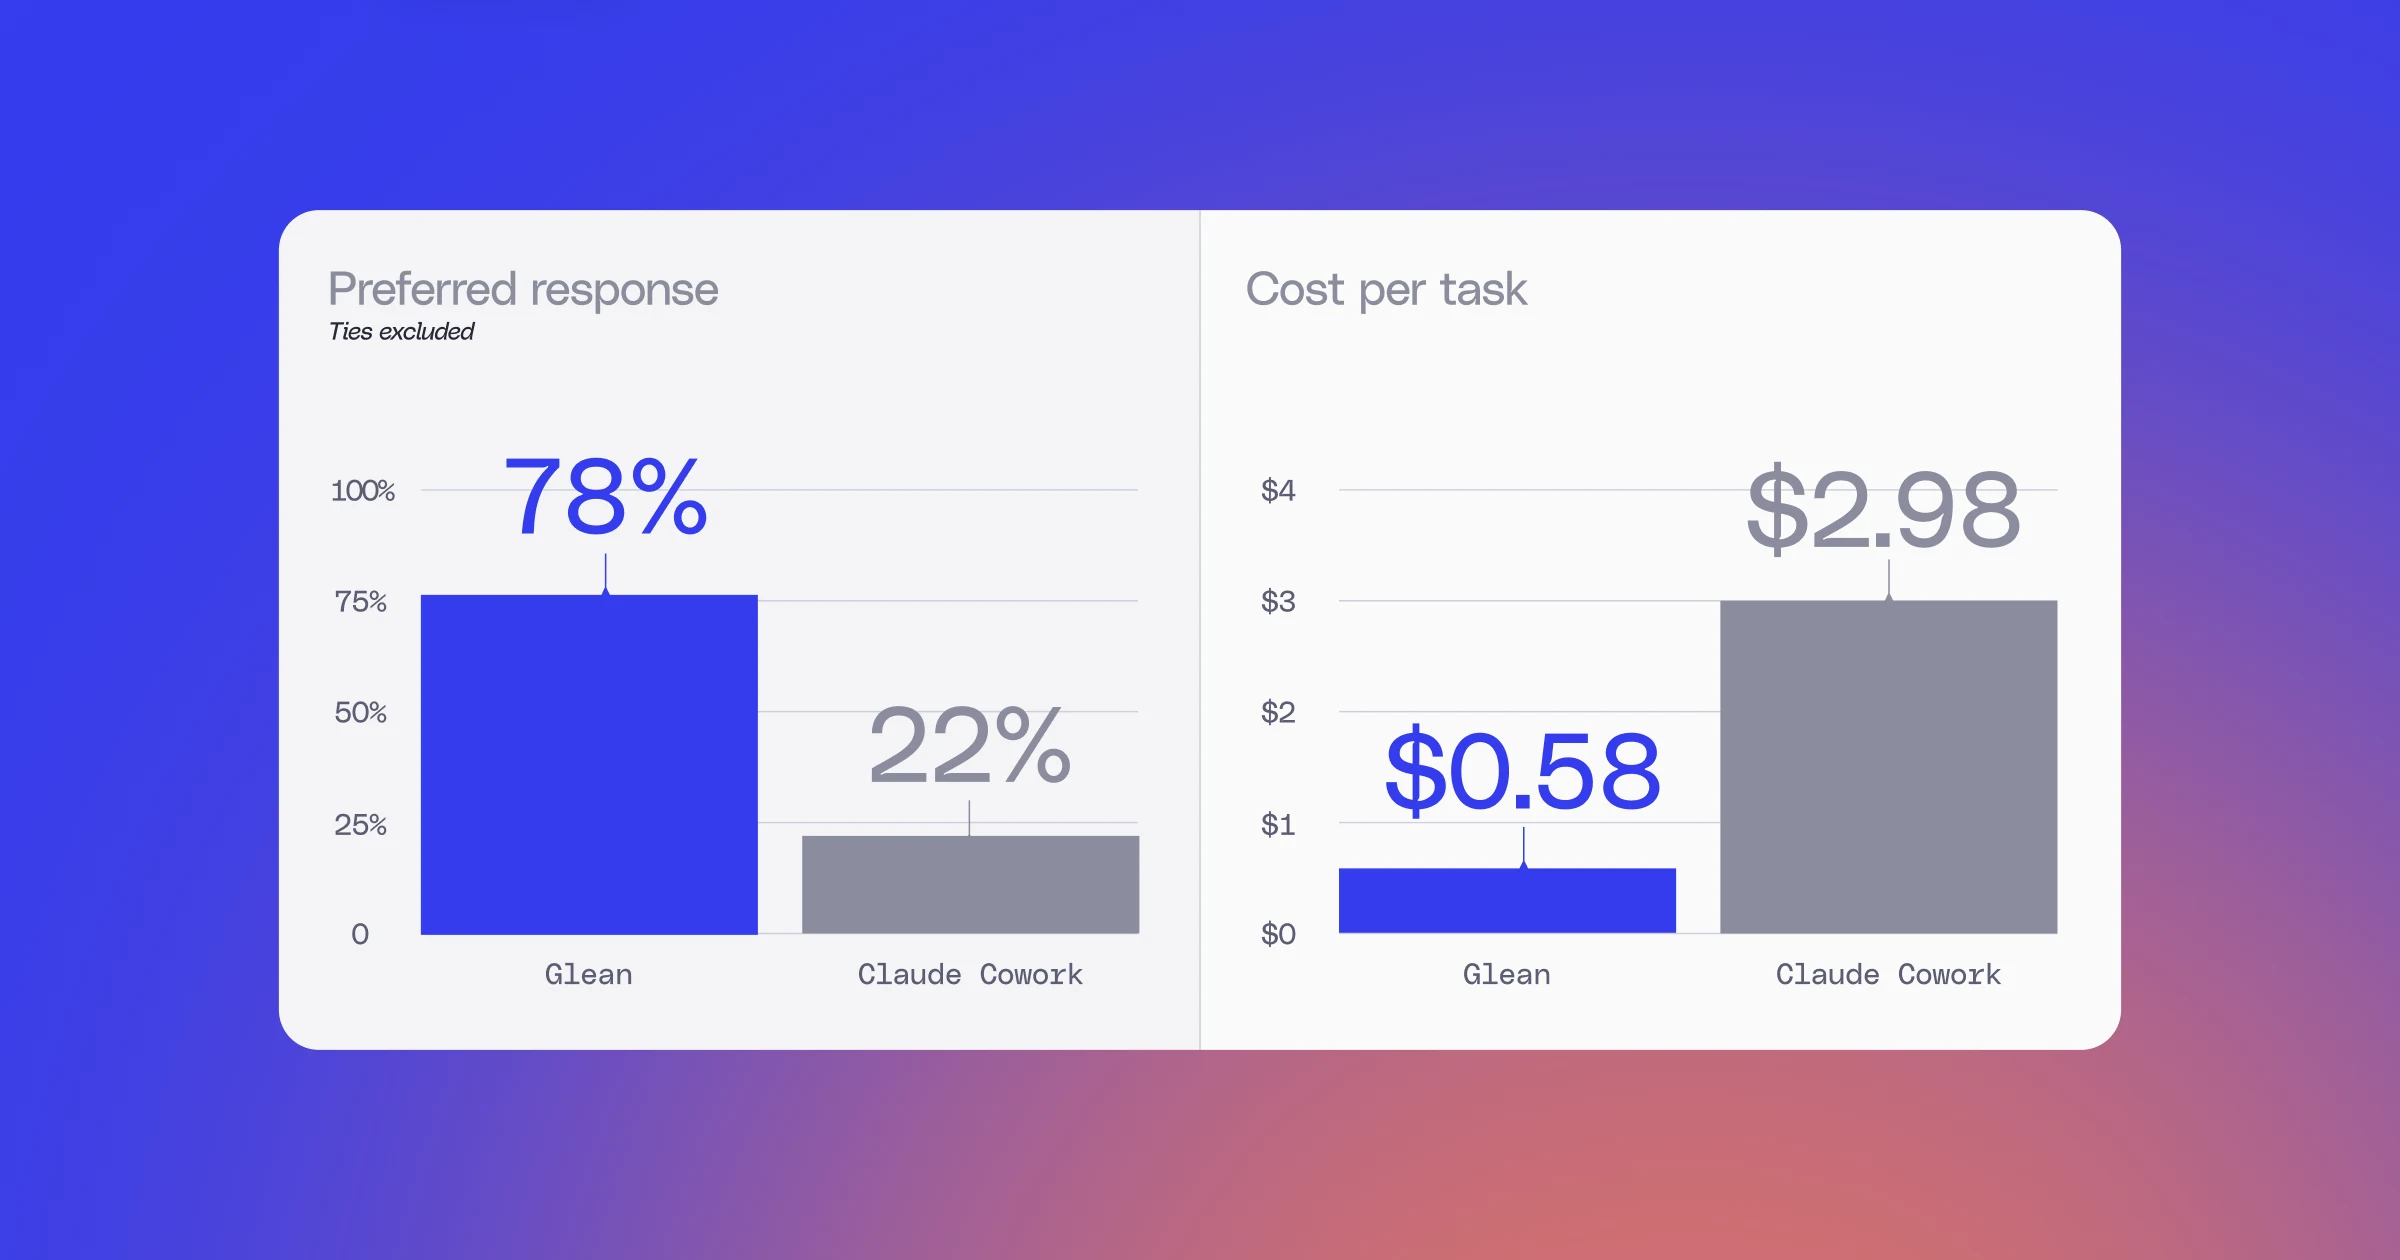
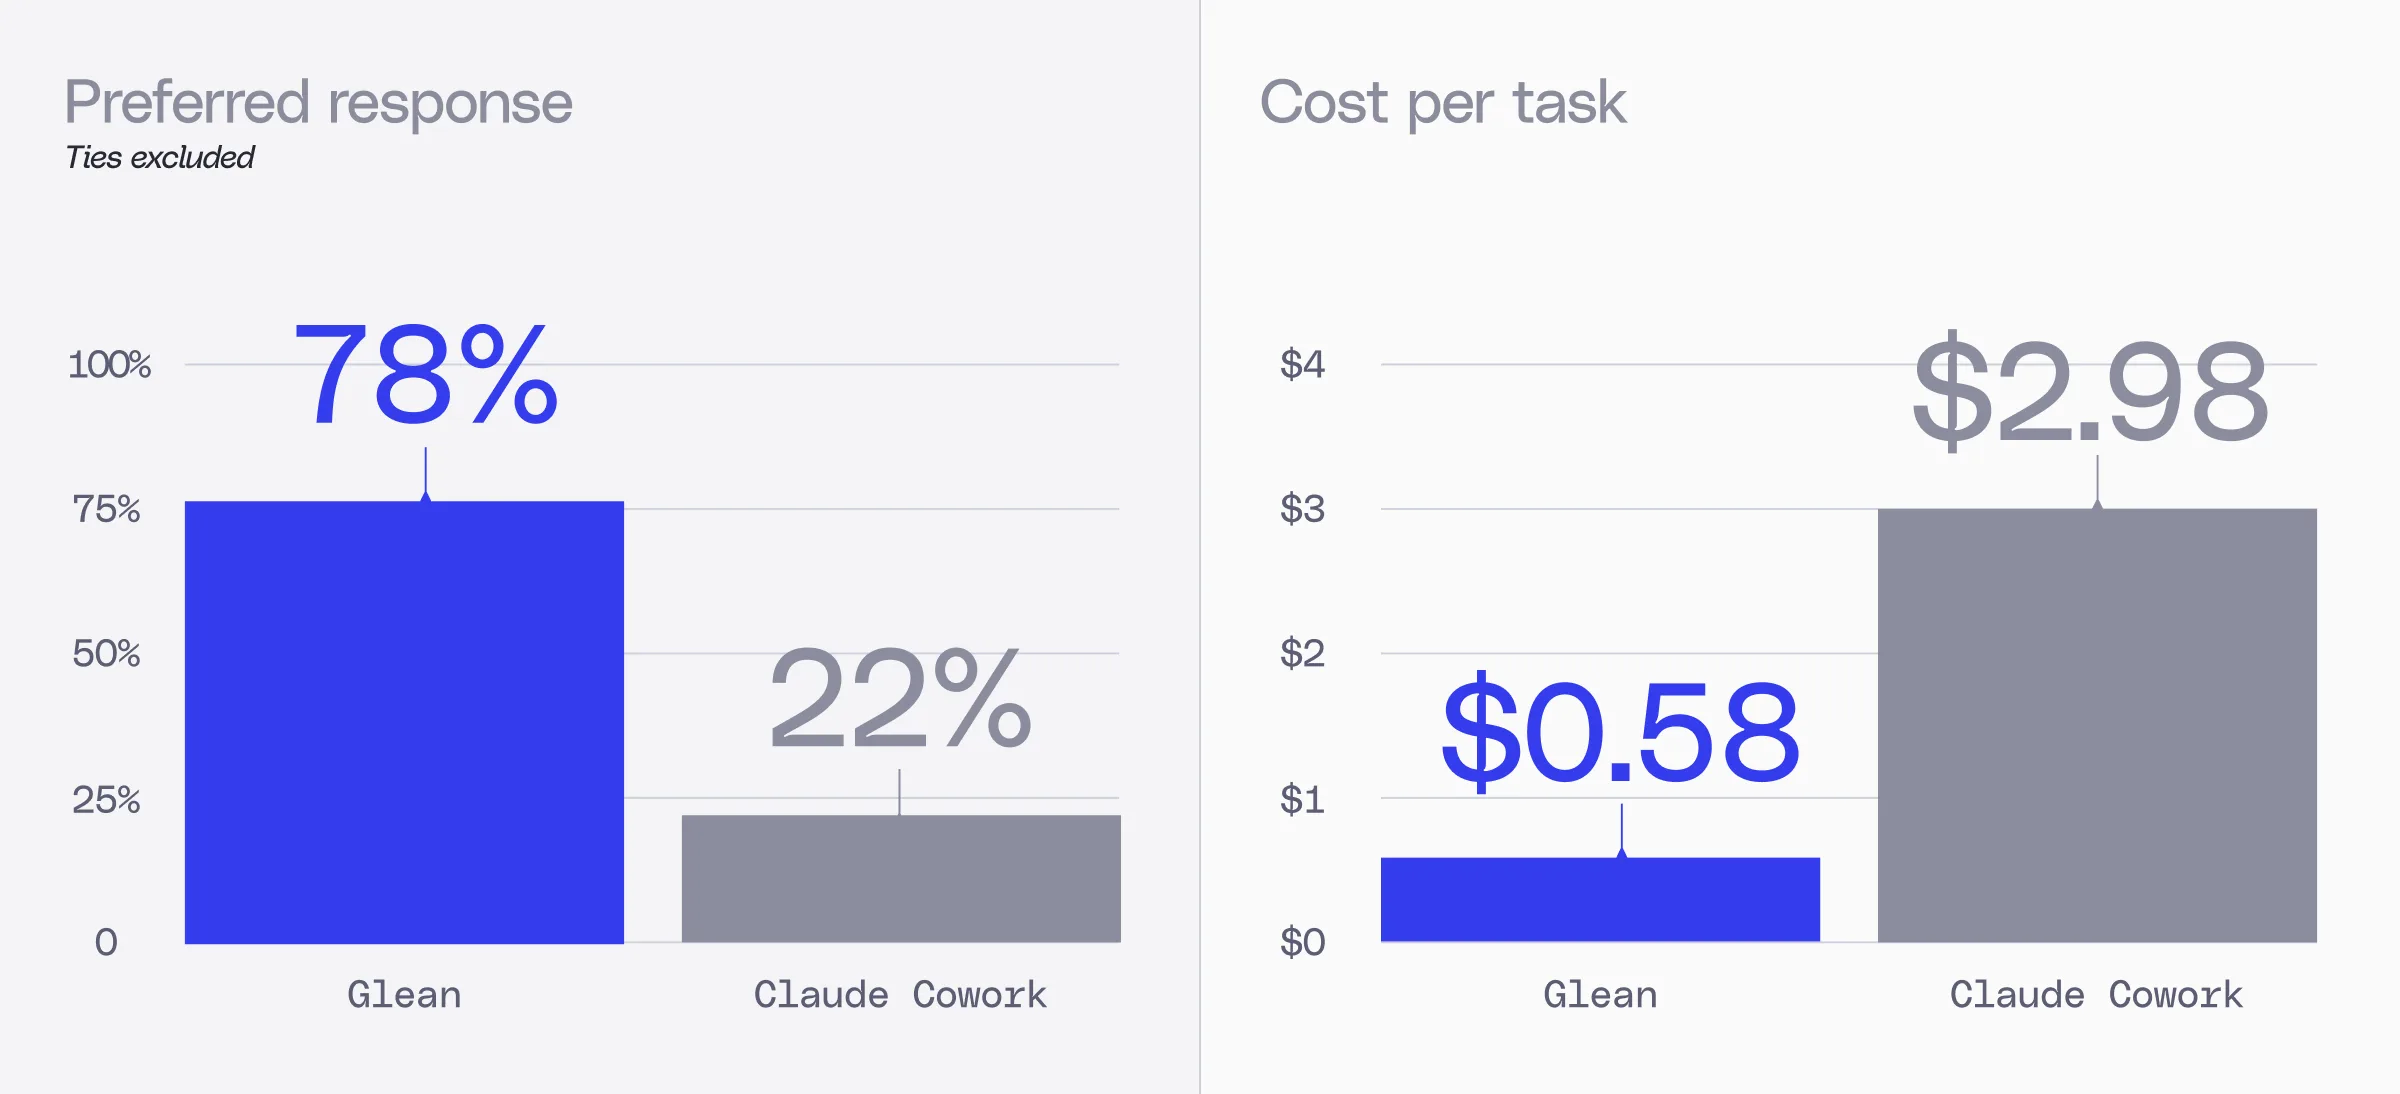
Nous avons mené deux analyses qui se complètent pour le démontrer. Tout d'abord, nous avons comparé en interne Glean Assistant, avec le routage automatique activé, à Claude Cowork utilisant le modèle qu'il recommande pour le travail quotidien, Claude Sonnet 5, sur plus de 180 tâches d'entreprise. Glean a permis d'économiser 81 % sur les coûts de tokens et a été choisi comme la meilleure réponse dans 78 % des cas. Claude Cowork affichait une moyenne de 2,98 $ par tâche ; Glean se situait à 0,58 $.
Ensuite, nous avons construit une analyse de la frontière de Pareto qui cartographie les compromis entre coût et performance à travers le paysage plus large des modèles sur des tâches d'entreprise, et cette analyse aide à éclairer la façon dont Glean prend ses décisions de routage automatique. Grâce au routage automatique, Glean associe les tâches aux modèles et à leurs niveaux de raisonnement en fonction de l'effort et des capacités requis.
Le coup de fouet des tokens en 2026
Le tokenmaxxing était en vogue au début de 2026, les entreprises suivant celui qui consommait le plus de tokens comme indicateur de productivité. Le retour de bâton n'a pas tardé : Uber a révélé avoir épuisé la totalité de son budget 2026 consacré au codage IA en seulement quatre mois, ServiceNow rapportant le même sort quelques semaines plus tard, son DSI qualifiant cela de « problème vraiment difficile ». À mesure que de nouveaux modèles de pointe continuaient de sortir et que le codage agentique s'imposait davantage dans le courant dominant, les entreprises sont parvenues à la même conclusion : miser sur un seul modèle de pointe, sans aucune discipline quant à la façon dont il est réellement utilisé, est une habitude coûteuse.
Le mois dernier a bouleversé le paysage des modèles. De nouveaux modèles ouverts comme GLM 5.2, Kimi K3 et DeepSeek V4 Flash ont fait leur entrée à des prix plus bas, parallèlement aux propres baisses de prix d'OpenAI sur GPT-5.6 Luna et Terra en juillet. Et les entreprises ont réagi, nombre d'entre elles ajoutant davantage de modèles ouverts à leur palette, et les plateformes d'inférence et de mise à disposition de modèles qui les prennent en charge voient par conséquent leur part de marché augmenter.
Analyse de la frontière de Pareto : évaluer conjointement les modèles sur le coût et la qualité
Avec un tel écart entre coût et capacité, nous avons mené une analyse distincte pour voir comment ces modèles se comparent en matière d'intelligence par rapport au coût, cette fois sur un ensemble plus large de 1 000 tâches d'entreprise, à travers 37 modèles et configurations d'effort de raisonnement dans un environnement de production. Cette analyse nous offre la précision nécessaire pour observer comment différents types de tâches se comportent selon les modèles, et pour utiliser ces conclusions afin d'optimiser les décisions de routage.
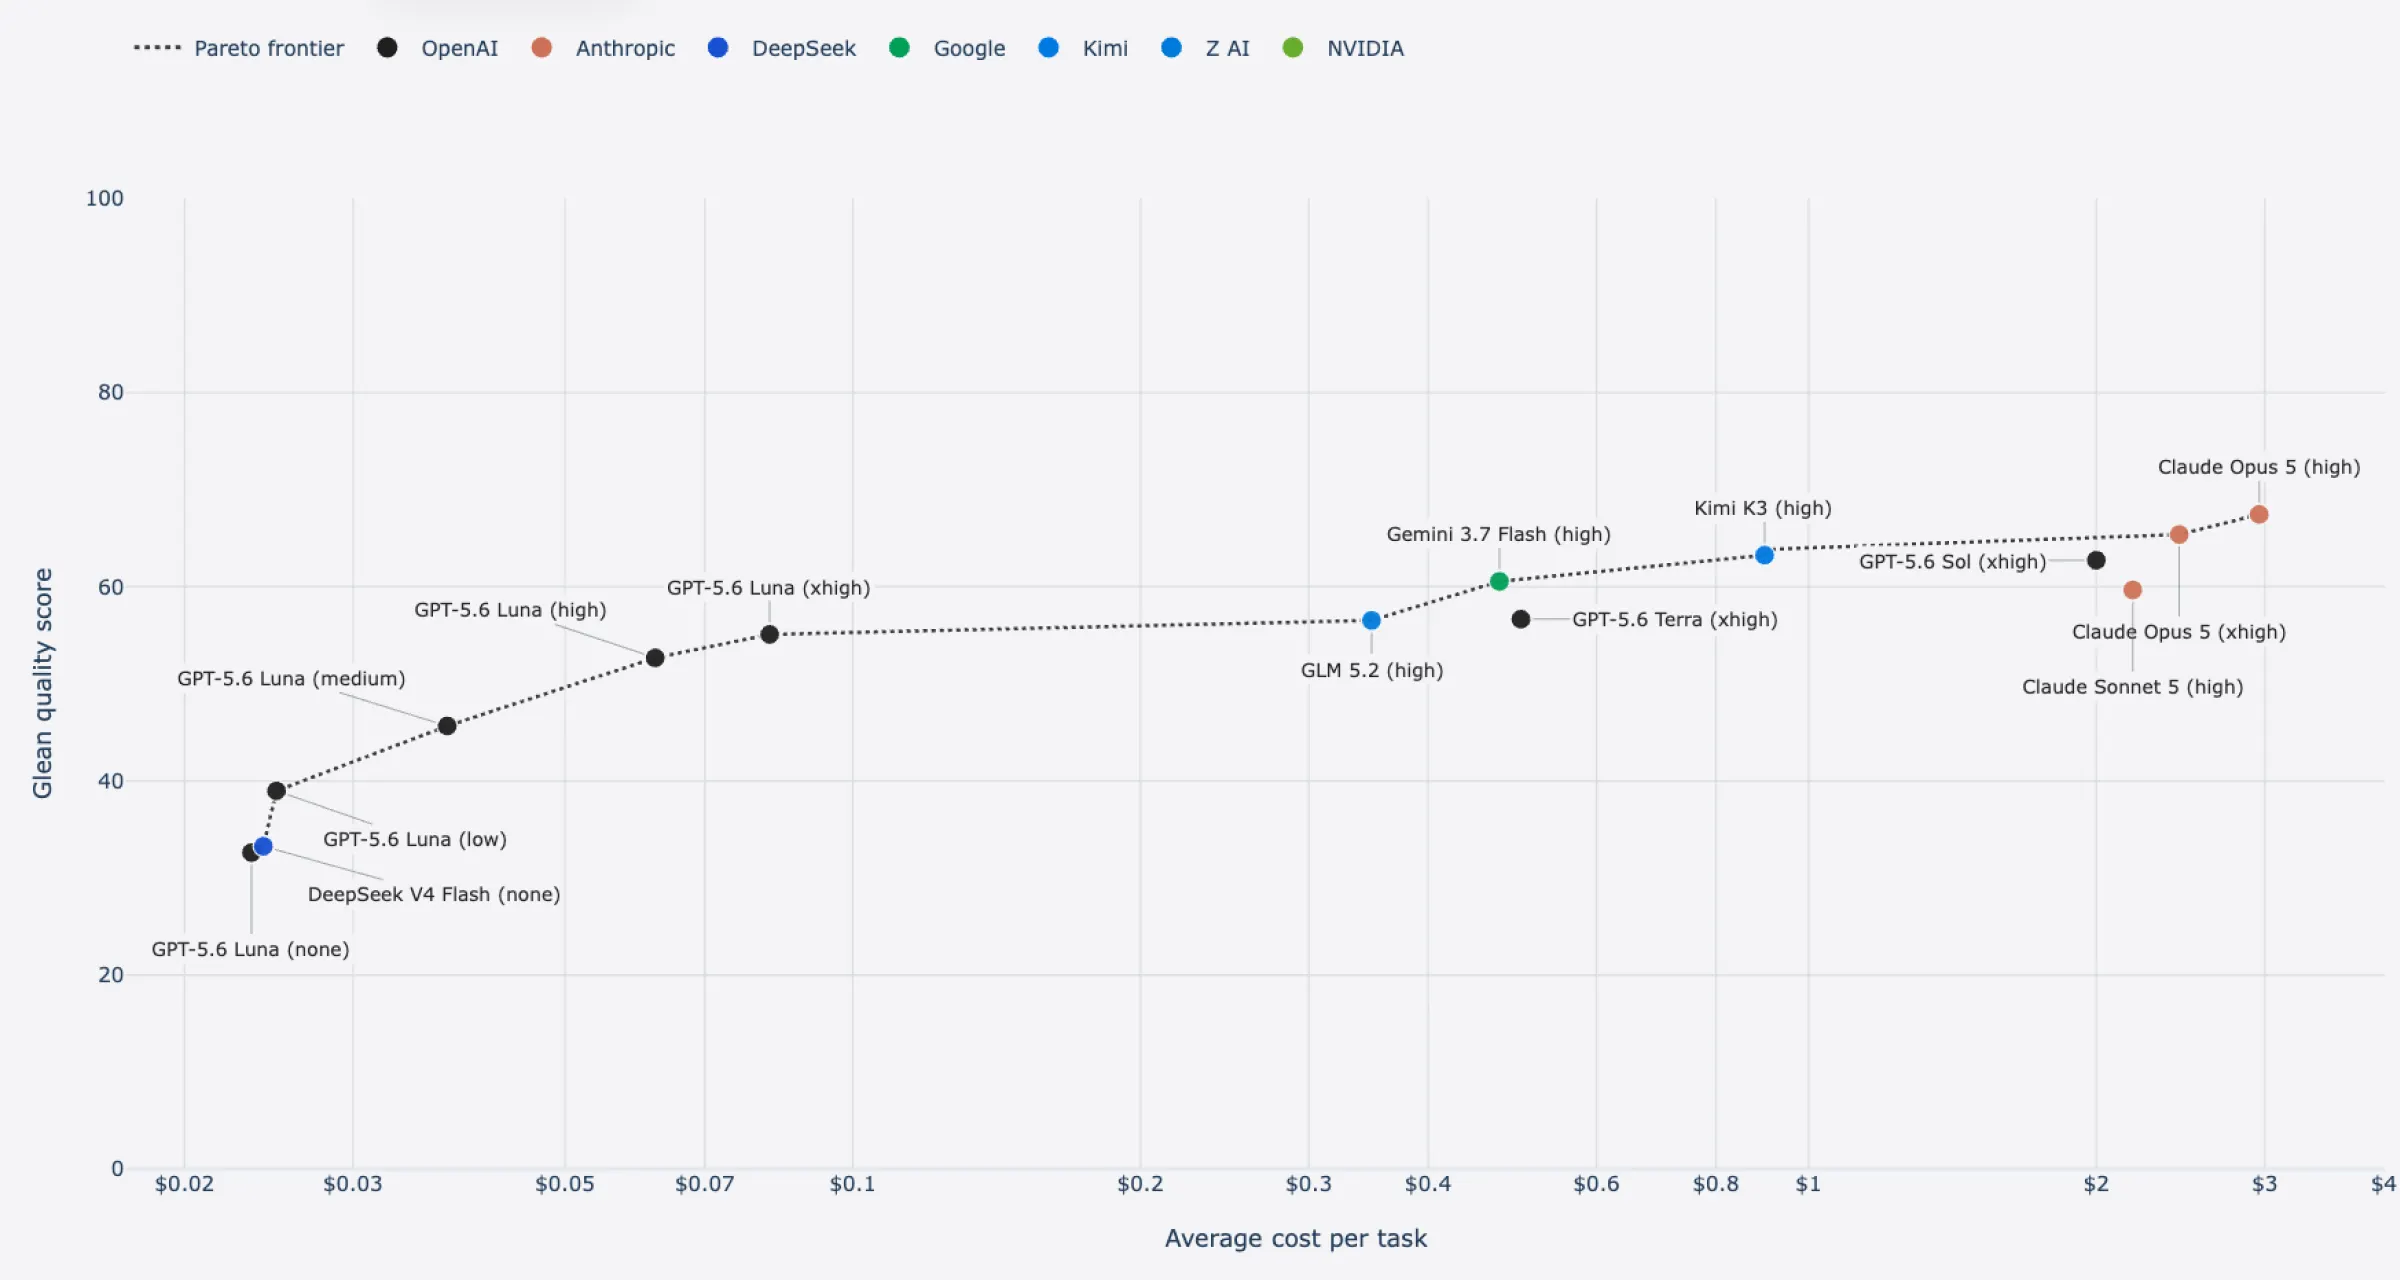
Pour donner du sens à ce compromis, nous nous sommes tournés vers la frontière de Pareto : l'ensemble des modèles offrant le meilleur compromis possible entre performance et coût. Un modèle est optimal au sens de Pareto si aucune autre option n'offre de meilleures performances à son niveau de prix, ou, de manière équivalente, si aucun modèle moins cher n'est disponible à son niveau de performance. Représentés sous forme de courbe, les modèles peu coûteux et moins performants se situent en bas à gauche, les modèles coûteux et très performants se situent en haut à droite, et la ligne qui les relie trace la frontière optimale.
L'analyse de Glean est unique en ce que la plupart des frontières de Pareto sont généralement construites à partir de jeux de données publics et ne sont pas adaptées à la complexité et à la diversité du travail en entreprise. La frontière de Pareto de Glean est calculée sur la base d'une évaluation sécurisée du trafic de production en entreprise, à l'aide de méthodes qui ne rendent visibles aux évaluateurs que des statistiques agrégées.
Pour construire le graphique de la frontière de Pareto, Glean a évalué les réponses des modèles en face à face, requête par requête, à l'aide d'un juge agentique axé sur l'exactitude, l'accomplissement des tâches et la qualité de la réponse finale. Notre conception de comparaison combinait un tournoi en round-robin entre les 11 familles de modèles à leurs niveaux de raisonnement par défaut avec des comparaisons entre niveaux de raisonnement adjacents au sein de chaque famille, pour un total de 81 confrontations par paires de modèles. Nous avons utilisé la méthodologie Bradley–Terry, une technique statistique standard permettant de transformer des résultats de confrontations en face à face en une note relative unique, afin de calculer le score de qualité Glean. Ce score représente la performance de préférence attendue d'un modèle face à l'ensemble de référence : un score de 60 signifie que le modèle est censé l'emporter en qualité sur 60 % des tâches lors d'une confrontation en face à face contre un concurrent choisi au hasard, les égalités étant réparties à parts égales dans cette analyse. Des scores plus élevés sont meilleurs, un score de 50 indiquant le milieu de la distribution de qualité.
Voici ce que nous avons constaté :
- GPT-5.6 Luna (xhigh) se situe sur la frontière, avec un score de qualité Glean de 55 tout en restant très rentable à 0,0819 $.
- GLM 5.2 (high), pour les amateurs de modèles open source, est légèrement supérieur à GPT-5.6 Luna (xhigh) avec un score de 57, mais à un coût plus élevé de 0,3489 $.
- Claude Opus 5 (high) se situe également sur la frontière, avec un score de 67, mais à un coût bien plus élevé de 2,9605 $.
- Kimi K3 (high) représente un juste milieu plus équilibré, obtenant des gains de qualité significatifs par rapport à GPT-5.6 Luna avec un score de 63 et un coût de 0,8995 $.
- Gemini 3.7 Flash (high) en est un autre exemple, avec un score de 61 et un coût de 0,4748 $.
Ce que cette analyse montre, c'est que la frontière n'est dominée par aucun fournisseur unique, et que l'écart de coût entre Luna 5.6 (xhigh) et le modèle le plus cher situé sur la frontière, Opus 5 (high), est de 36x pour un gain de 22 % du score de qualité. De plus, plusieurs modèles comme Kimi K3 et Gemini 3.7 Flash (high) peuvent capturer des gains de qualité par rapport à GPT-5.6 Luna (xhigh), tout en coûtant 3 à 6 fois moins cher qu'Opus 5 (high).
Ces enseignements montrent qu'il n'existe pas de modèle unique « meilleur » et qu'il existe une plage optimale, c'est pourquoi le choix du modèle et le routage automatique peuvent atteindre cette qualité à une fraction du coût. Les évaluations de la frontière de Pareto rejoignent les milliers d'évaluations que Glean réalise chaque trimestre pour éclairer ses décisions de routage.
Comment fonctionne le routage automatique de Glean
Le routage automatique est l'approche de Glean pour associer le bon modèle, au bon niveau de raisonnement, à la tâche à accomplir, afin qu'aucun utilisateur n'ait besoin d'être un expert en modèles et de réfléchir à celui qu'il doit choisir. Nous abordons le routage sous deux angles. Le premier est la sélection du modèle : lequel des plus de 40 modèles ouverts et de pointe disponibles est le mieux adapté à une tâche donnée. Le second est le routage de l'effort : à quel point le modèle doit réfléchir, en utilisant le niveau de raisonnement comme levier.
Pour déterminer le niveau de raisonnement optimal à l'exécution, Glean utilise un petit modèle spécialisé, Glean Waldo, post-entraîné sur NVIDIA Nemotron 3 Nano. Une fois que Waldo a déterminé le niveau de raisonnement, il peut déléguer à un modèle spécialisé si nécessaire pour accomplir la tâche. Nous avons constaté, par exemple, que Claude Opus 4.8 excelle dans la création d'artefacts visuels, de sorte que le harness passe à Opus 4.8 selon sa compréhension de la tâche.
Analyse comparative : Glean face à Claude Cowork pour les travaux par département
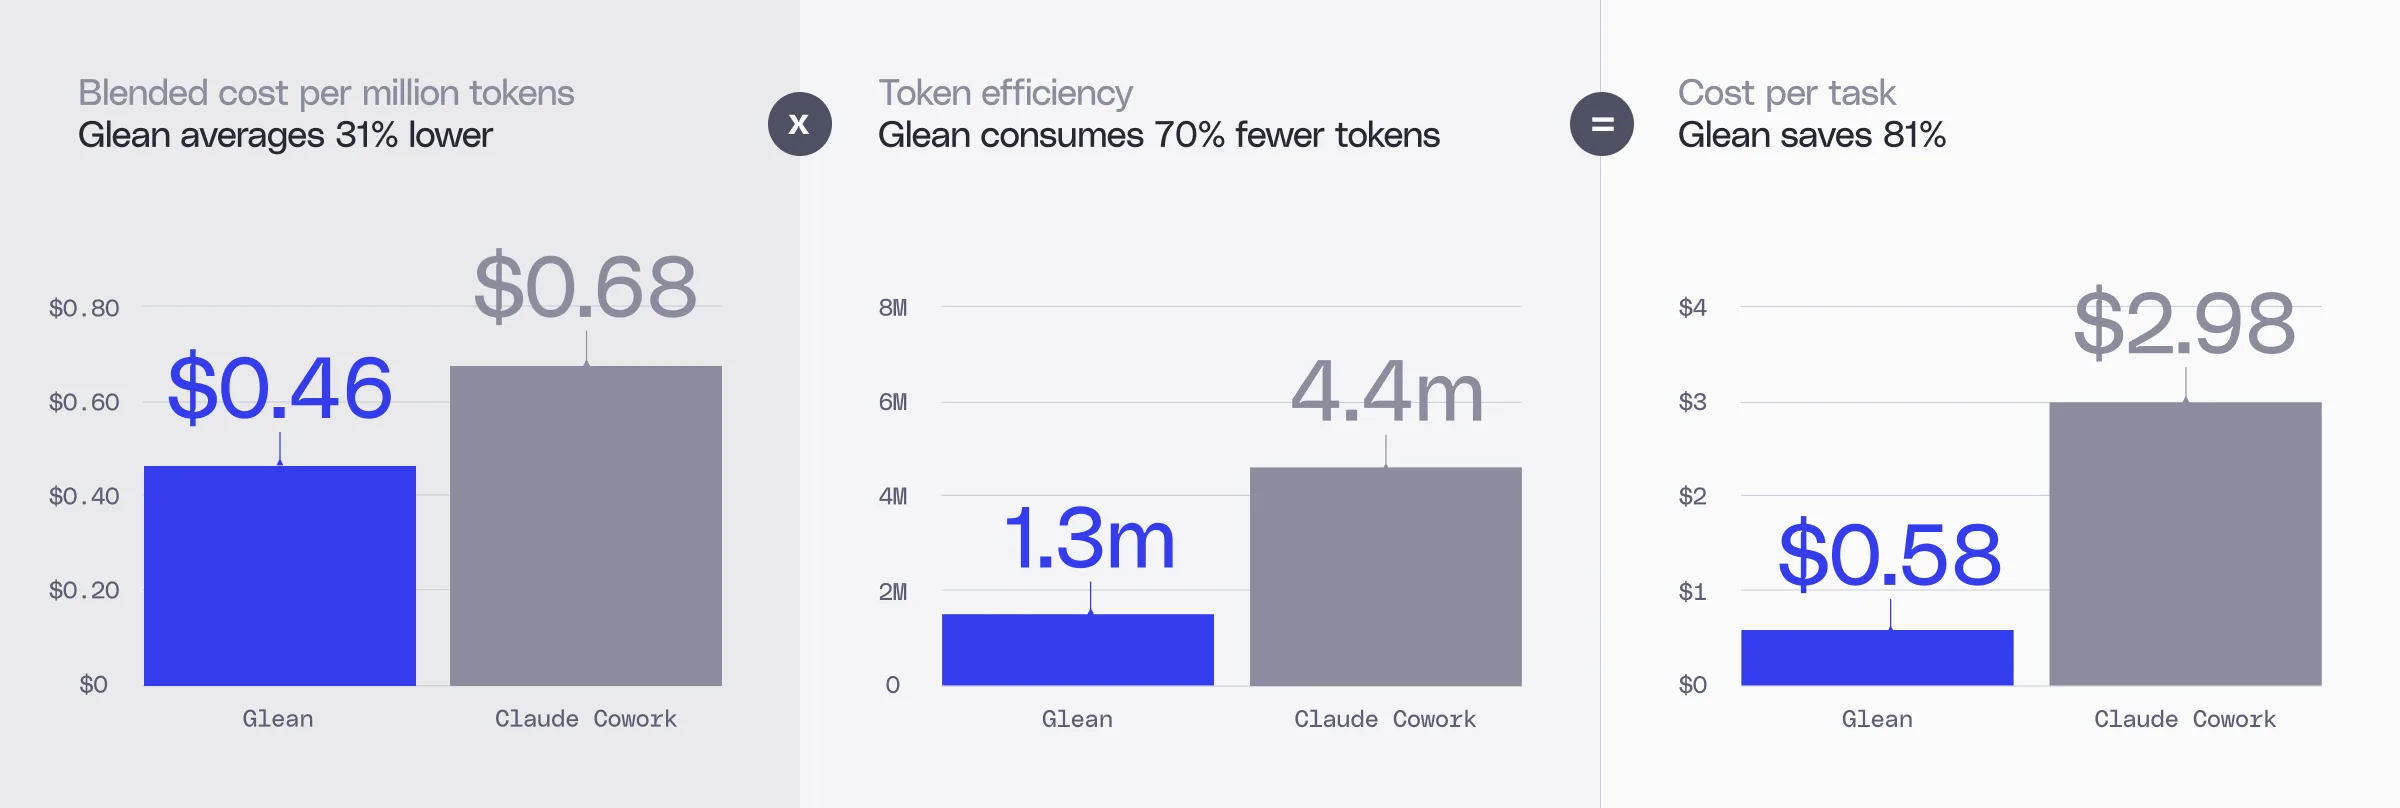
Glean offre un coût par tâche inférieur sur la base de deux indicateurs d'entrée. Le premier est le coût moyen de chaque token sur l'ensemble des modèles utilisés par le routage automatique. Le second est le nombre de tokens utilisés. Glean a utilisé moins de tokens, 1,3 million contre 4,4 millions pour Claude Cowork, soit une réduction de 70 %. Combinés, ces facteurs ont fait baisser le coût moyen de Glean à 0,58 $ par tâche, contre 2,98 $ pour Cowork.
Si nous avons réalisé une réduction de 70 % de l'utilisation de tokens, c'est grâce à des décisions d'architecture propres à Glean :
Glean offre un coût par tâche plus faible sur la base de deux indicateurs d'entrée. Le premier est le coût mixte de chaque token sur l'ensemble des modèles utilisés par le routage automatique. Le second est le nombre de tokens utilisés. Glean a utilisé moins de tokens, 1,3 million contre 4,4 millions pour Claude Cowork, soit une réduction de 70 %. Combinés, ces éléments ont ramené le coût moyen de Glean à 0,58 $ par tâche, contre 2,98 $ pour Cowork.
La raison pour laquelle nous avons obtenu une réduction de 70 % de l'utilisation des tokens repose sur des décisions architecturales propres à Glean :
- Fondations du contexte d'entreprise : Glean part d'une vue unifiée, pré-indexée et classée des informations de l'entreprise, tandis que l'approche fédérée MCP de Claude Cowork doit interroger chaque système individuellement, récupérant souvent trop de résultats et consommant des tokens pour normaliser les données, résoudre les conflits et répéter des boucles de raisonnement dont il ne devrait pas avoir besoin.
- Conception du harness : Glean conserve les sorties des outils et l'état intermédiaire dans des fichiers sandbox au lieu de tout recharger dans la fenêtre de contexte du modèle à chaque fois. Il charge progressivement uniquement les outils, compétences et schémas dont une tâche a besoin, tandis que des sous-agents isolés maintiennent également le contexte non pertinent hors de la boucle de raisonnement principale.
Analyse comparative : Glean atteint une qualité supérieure à Claude Cowork pour un coût inférieur
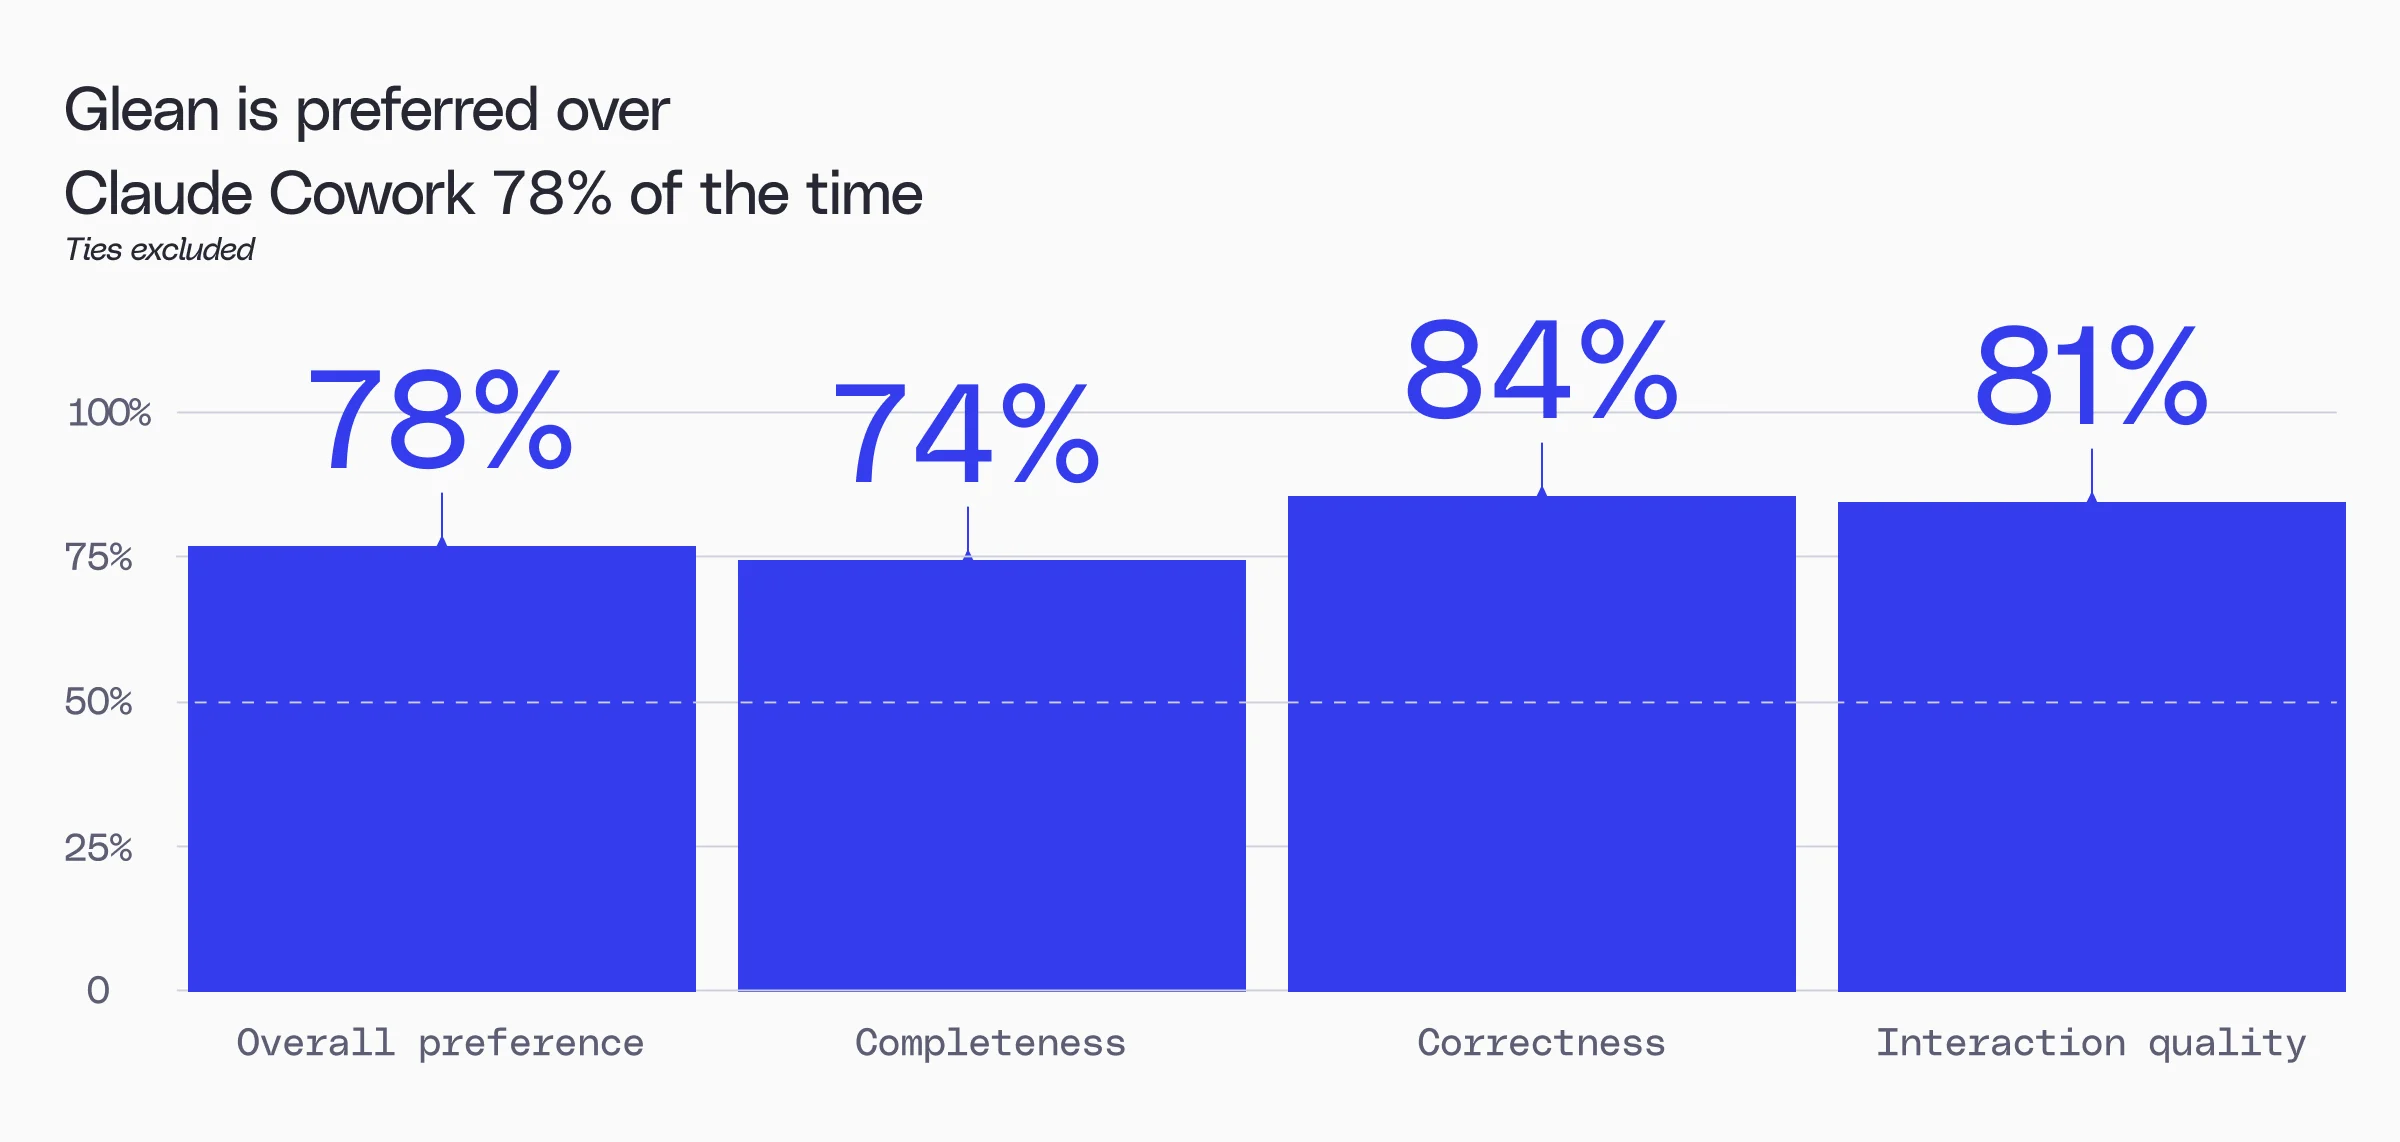
L'efficacité en matière de coût n'a d'importance que si le résultat est utilisable, et c'est là qu'intervient la qualité. Glean a été préféré 78 % du temps par rapport à Claude Cowork sur plus de 180 requêtes, en l'emportant sur :
- Préférence globale : quelle réponse ils utiliseraient réellement dans leur travail
- Exactitude : quelle réponse était la plus factuellement exacte, logiquement solide et ancrée dans des sources actuelles
- Complétude : quelle réponse répondait le mieux à la demande et laissait le moins de travail inachevé
- Qualité de l'interaction : quel système nécessitait le moins d'orientation, de correction, de nouvelles sollicitations, d'attente ou de sauvetage manuel
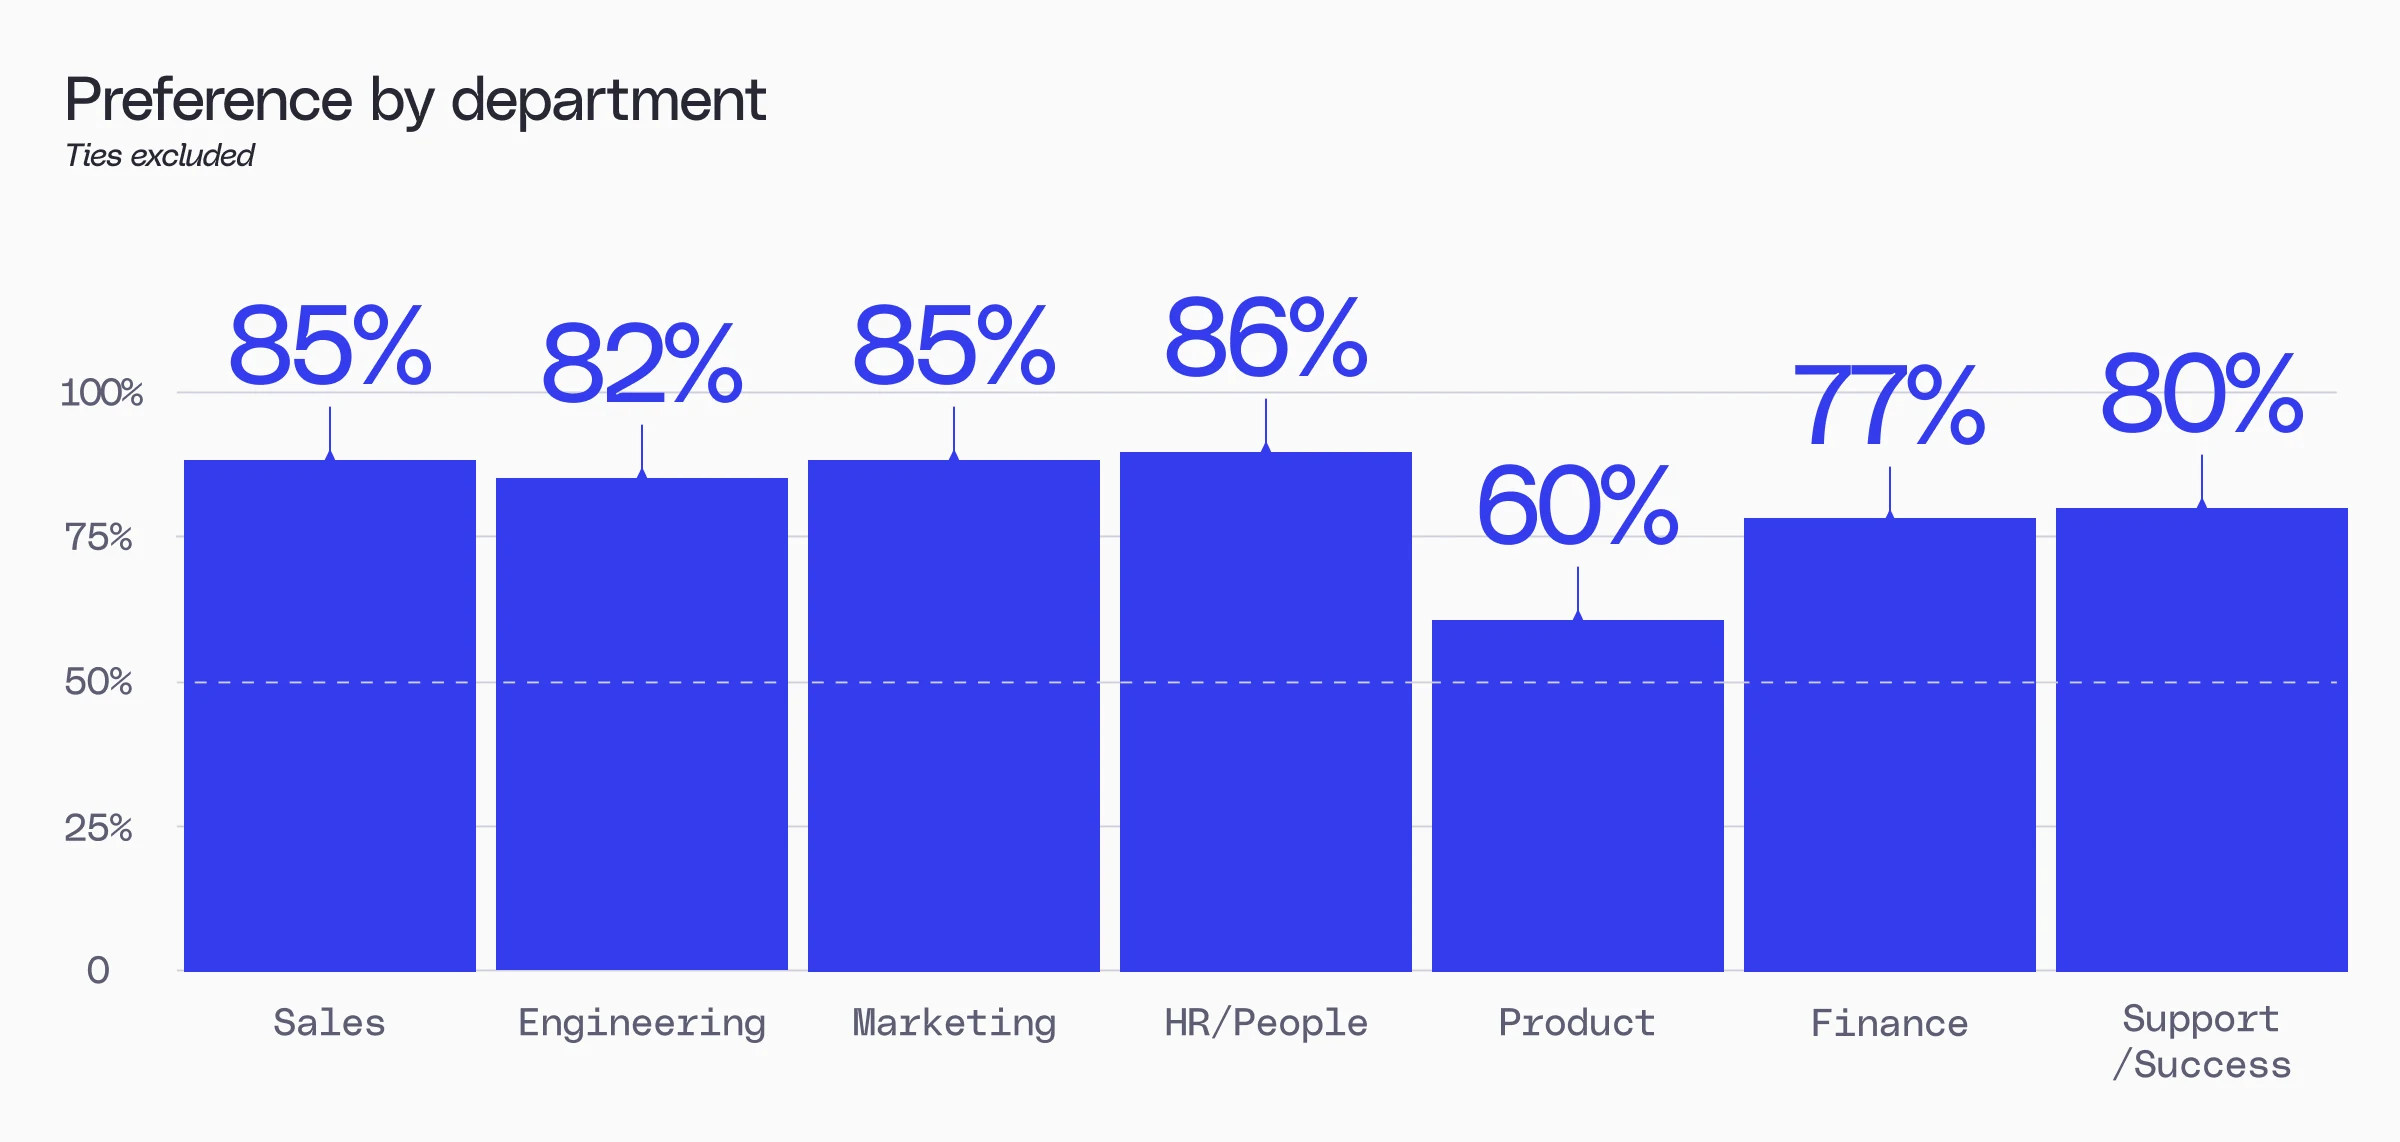
La préférence pour Glean s'est maintenue dans chaque département évalué, y compris les ventes, l'ingénierie, le marketing, les ressources humaines, le produit, la finance, ainsi que l'assistance et la réussite client. Les tâches sélectionnées pour l'ensemble d'évaluation ont été inspirées par la façon dont les clients utilisent Glean aujourd'hui, bien que toutes les requêtes aient été générées de manière synthétique afin de protéger la confidentialité des utilisateurs. Les tâches ont été examinées par des experts en la matière dans chaque domaine, les membres de l'équipe commerciale vérifiant les tâches de vente, les spécialistes du marketing vérifiant les tâches marketing, et ainsi de suite, afin de garantir qu'elles soient représentatives de leur travail.
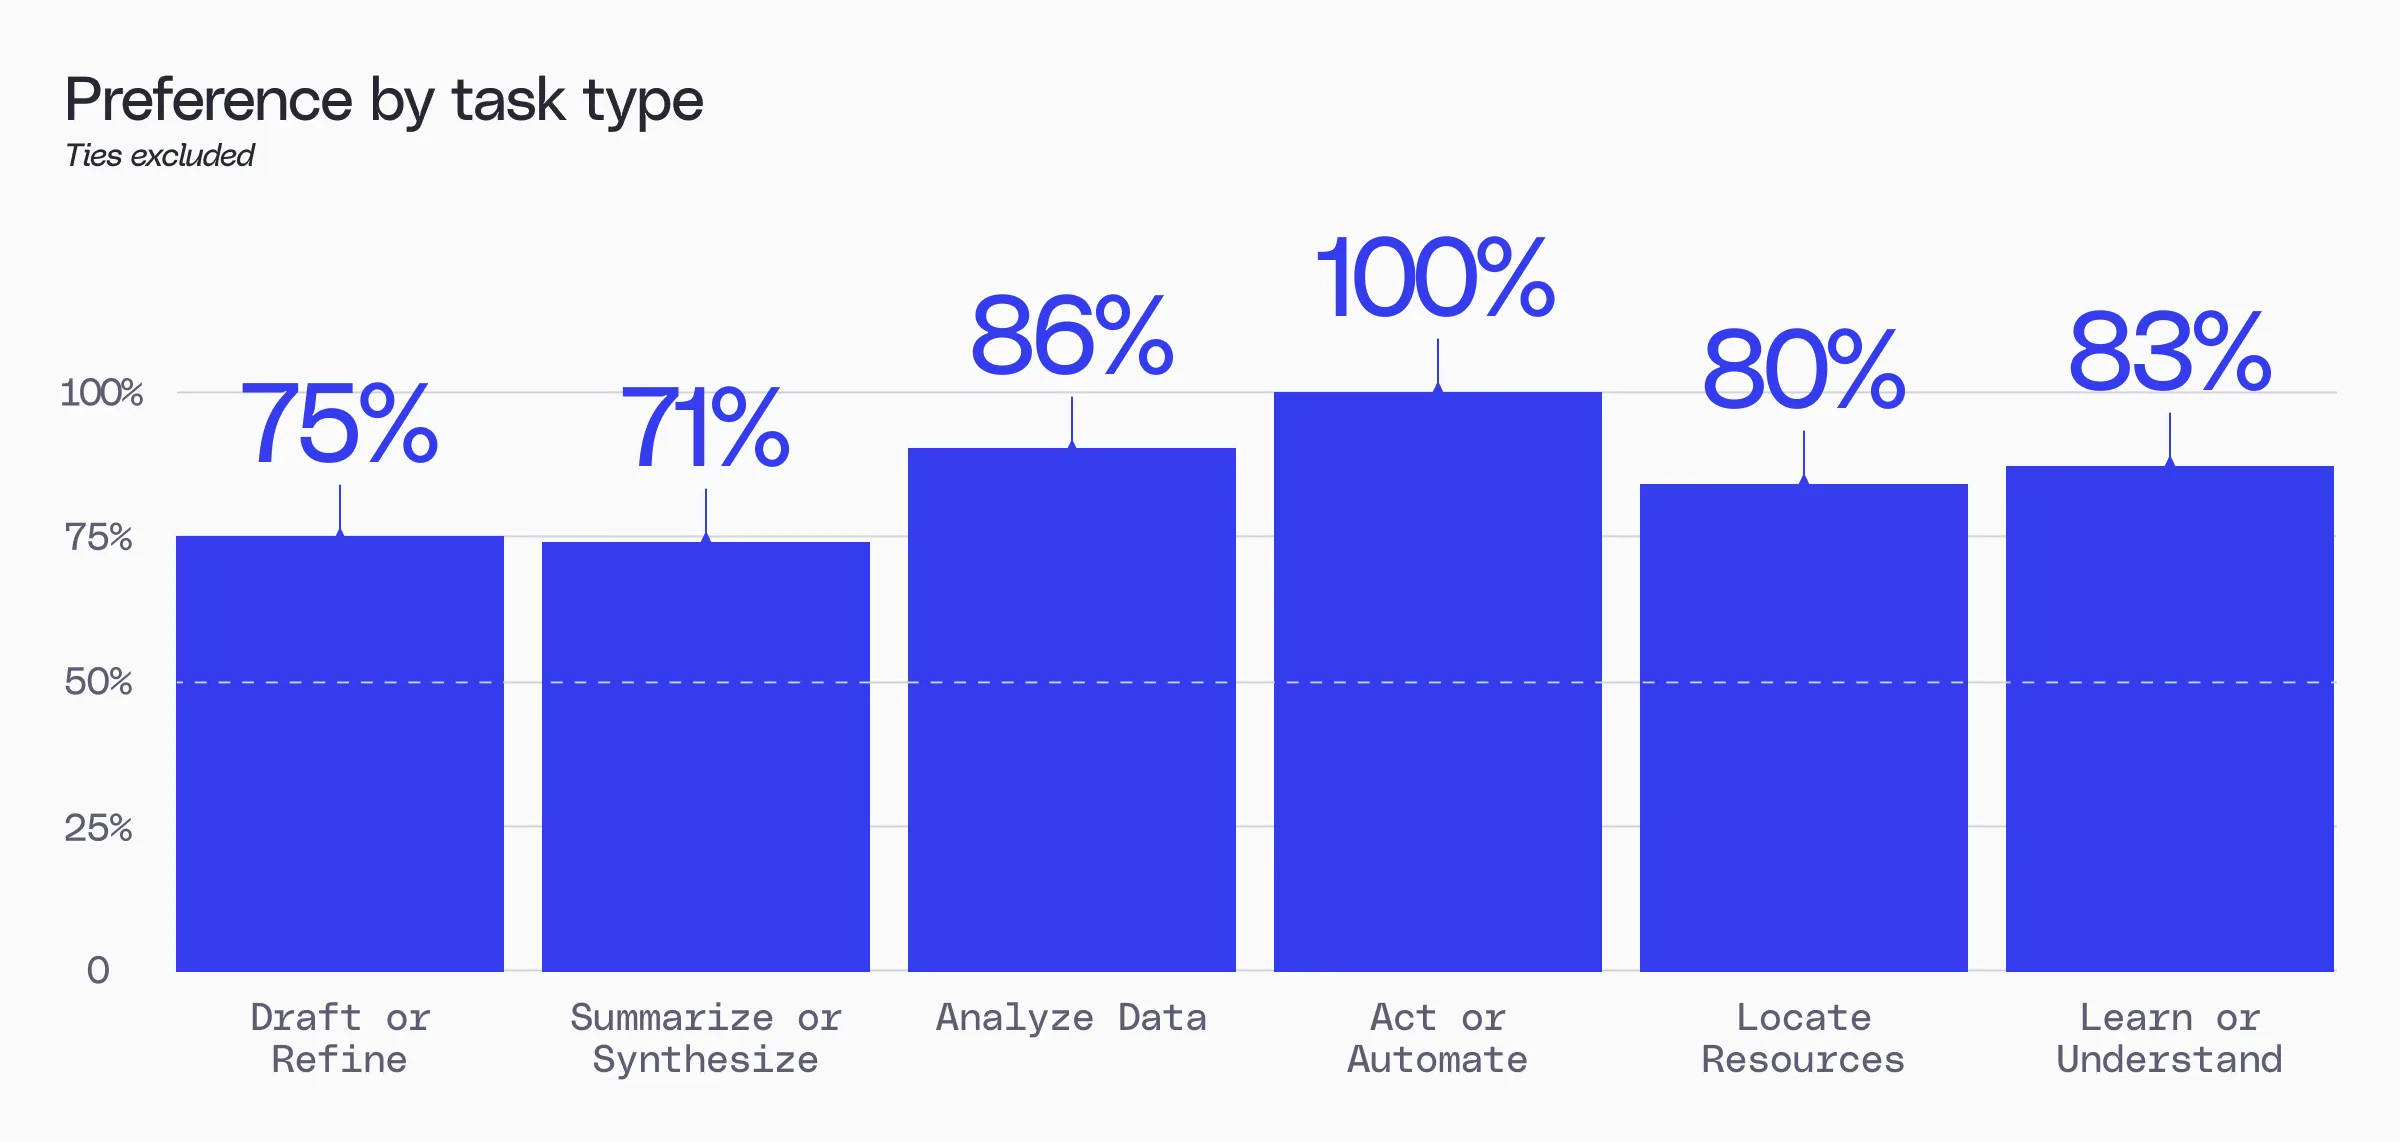
L'avantage de Glean s'est également maintenu quels que soient les types de tâches. L'ensemble d'évaluation couvrait toute la gamme des travaux d'entreprise : rédaction et affinage de contenu (y compris des artefacts comme des diapositives, des feuilles de calcul et du HTML, de plus en plus centraux dans les cas d'usage de collaboration en entreprise), résumé et synthèse de sources, analyse de données, localisation de ressources, automatisation de flux de travail et compréhension de sujets complexes.
Analyse comparative : les réponses préférées de Glean aident à lutter contre le botsitting
Nous avons également constaté que les réponses préférées de Glean réduisent le botsitting, ce travail largement non budgété que les employés assument pour rendre l'IA utilisable, en lui fournissant du contexte, en supervisant les résultats et en corrigeant les erreurs. Une recherche du Work AI Institute de Glean, menée auprès de 6 000 travailleurs numériques à temps plein, a révélé que les employés consacrent 6,4 heures par semaine au botsitting, soit plus de temps qu'ils n'en passent à utiliser l'IA pour produire réellement du travail. Les retours de nos propres évaluateurs ont fait ressortir des schémas d'échec qui génèrent ce type de travail de correction :
- Des tâches mal interprétées
- Des résultats difficiles à lire ou à partager
- Des rôles ou un contexte de compte manquants
- Des preuves incomplètes ou obsolètes
- Des conclusions non étayées, voire incorrectes
Chacun de ces éléments constitue une petite taxe imposée à la personne qui utilise le résultat, précisément ce travail que le Work AI Institute quantifie sous le terme de « botsitting ». Lorsqu'un système démarre avec le bon contexte déjà en place, il nécessite moins de corrections de ce type, et les collaborateurs récupèrent les heures qu'ils auraient autrement consacrées à gérer l'IA.
Analyse du benchmark : méthodologie d'évaluation
L'évaluation interne reposait sur des requêtes synthétiques accédant aux propres données de production de Glean, des évaluateurs notant plus de 180 réponses sur une échelle de préférence à 5 points, comparant Glean Assistant et Claude Cowork côte à côte. Pour l'accès aux données d'entreprise, Glean a utilisé ses connecteurs natifs et basés sur MCP, tandis que Claude Cowork a été configuré avec des connecteurs MCP prêts à l'emploi couvrant Google Drive, Gmail, Google Calendar, Slack, Atlassian Rovo, Linear, Intercom et Sigma, ainsi que des serveurs MCP locaux pour Salesforce, GitHub et GCP. Glean fonctionnait avec le routage automatique activé ; Claude Cowork a été maintenu constant sur Claude Sonnet 5 avec un raisonnement élevé, le niveau de raisonnement recommandé par Anthropic, qui équilibre qualité et rapidité.
L'essor de la frontière de Pareto et l'évaluation des modèles sur le rapport coût-performance
L'essor de la frontière de Pareto marque le déclin de l'intelligence maximale comme stratégie par défaut pour l'IA d'entreprise. Les entreprises n'ont plus à choisir entre ce que coûte l'IA et ce qu'elle apporte, et miser sur un seul modèle de pointe, sans discipline quant à la manière dont il est réellement utilisé, n'est pas une habitude durable. Les résultats de Glean le démontrent : associer le routage sur un paysage de modèles en évolution rapide au contexte d'entreprise réduit les coûts de tokens de 81 %, tandis que les résultats eux-mêmes sont préférés 78 % du temps. Glean s'engage à aider les entreprises à réduire considérablement leurs coûts de tokens afin qu'elles puissent élargir considérablement le travail qu'elles confient à l'IA.
Rejoignez-nous à Glean:GO pour en savoir plus sur ces résultats.
