






Jev est un modèle qui excelle dans la prise de décisions typées. C'est-à-dire que vous lui envoyez un contexte accompagné d'un ensemble fixe de questions et d'options, et il renvoie des choix, des scores et des probabilités au lieu de générer du texte. C'est ce que nous appelons un modèle « System One ».
Mais la classification n'a rien de nouveau, pas plus que les sorties structurées, les petits modèles ou la lecture de probabilités à partir des logits. Cette histoire explique en partie les réactions mitigées suscitées par Jev :
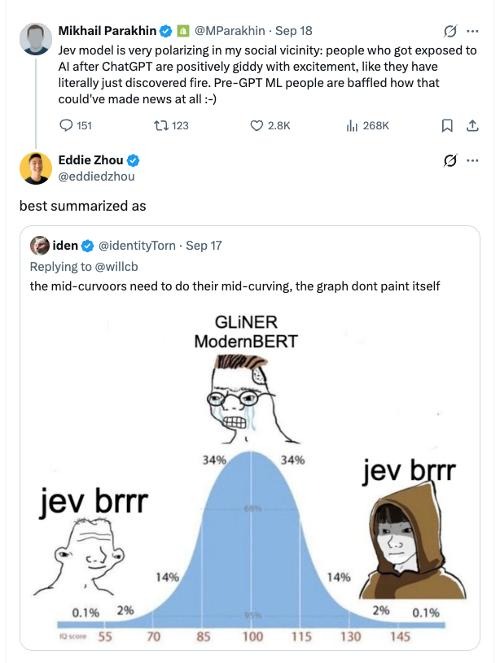
Les sceptiques soulèvent un point tout à fait valable, mais Jev a une réelle place dans cet écosystème. Pour mieux comprendre, il faut présenter l'ensemble des solutions possibles.
Quelles sont les alternatives ?
Lorsqu'un système a besoin d'une étiquette, d'un score ou d'une réponse par oui ou par non, il existe quatre options raisonnables :
<div class="overflow-scroll" role="region" aria-label="Approaches comparison">
<table class="rich-text-table_component">
<thead class="rich-text-table_head">
<tr class="rich-text-table_row">
<th class="rich-text-table_header" scope="col">Approche</th>
<th class="rich-text-table_header" scope="col">Pourquoi l'utiliser</th>
<th class="rich-text-table_header" scope="col">Compromis</th>
</tr>
</thead>
<tbody class="rich-text-table_body">
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Un LLM à usage général</td>
<td class="rich-text-table_cell">Zero-shot, flexible, et capable aussi de générer des arguments ou des explications. Potentiellement une « intelligence supérieure » grâce au calcul au moment de l'inférence (raisonnement).</td>
<td class="rich-text-table_cell">Payer la latence et le coût d'un modèle autorégressif pour une petite décision</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Un classifieur zero-shot ouvert</td>
<td class="rich-text-table_cell">Économique, local et contrôlable</td>
<td class="rich-text-table_cell">Qualité variable ; la sélection et le déploiement du modèle sont à votre charge</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Un classifieur affiné</td>
<td class="rich-text-table_cell">Généralement le meilleur choix pour une tâche stable, à fort volume et disposant de bonnes étiquettes</td>
<td class="rich-text-table_cell">Collecte de données, entraînement, déploiement, dérive et une taxonomie moins flexible</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Jev</td>
<td class="rich-text-table_cell">La flexibilité zero-shot derrière une API hébergée et épurée</td>
<td class="rich-text-table_cell">Qualité dépendante de la tâche, aucun texte généré et dépendance au fournisseur</td>
</tr>
</tbody>
</table>
</div>
L'argument en faveur de Jev : une équipe peut modifier la question et les options sans collecter un nouvel ensemble d'entraînement, tout en évitant le travail nécessaire pour bien déployer un modèle. Personne ne devrait faire la fine bouche devant cela. « On pourrait le construire nous-mêmes » est vrai de la plupart des produits d'infrastructure.
Les reproductions ouvertes relativisent la revendication de nouveauté. Des implémentations utilisant Qwen et SGLang, DiffusionGemma et vLLM, et Kev recréent une grande partie de la forme de l'API ou du modèle.
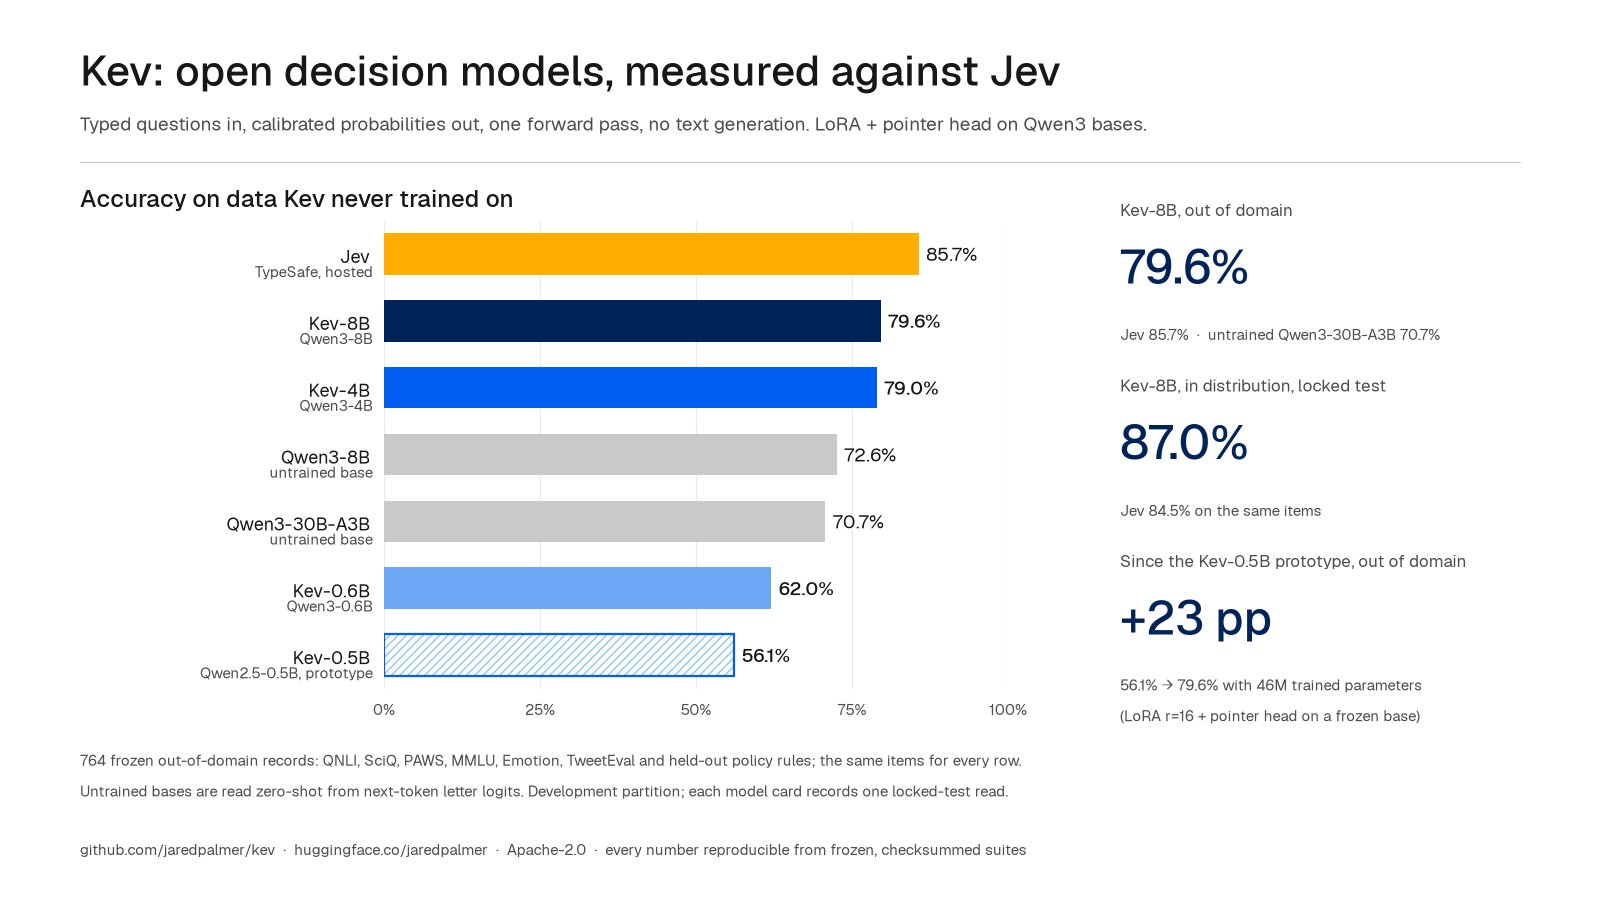
Les tests externes de Parallel ont de même constaté que Jev était compétitif sur le reclassement, tandis que des modèles spécialisés l'emportaient encore sur deux tâches de classification.
Ce que nous avons observé chez Glean
Reste une question pratique : quand la combinaison qu'offre Jev, entre flexibilité zero-shot et inférence hébergée, surpasse-t-elle réellement les alternatives ? Nous avons testé quatre décisions bornées chez Glean, pour lesquelles nous disposions déjà d'une référence et pouvions évaluer la qualité attendue en entreprise. La plupart de ces références sont des systèmes basés sur des LLM ; pour ces expériences, nous savons donc qu'il faut s'attendre à une amélioration de deux ordres de grandeur en matière de coût et de latence. Les résultats sont allés de nettement inférieurs à la production jusqu'à la fois plus rapides et plus précis qu'un routeur basé sur un LLM.
Classification des requêtes
La classification des requêtes associe une demande à une grande catégorie de tâche utilisée par les systèmes en aval. C'est une charge de travail naturelle pour Jev car, même si l'espace des étiquettes est connu à l'avance pour chaque requête, la taxonomie peut tout de même évoluer plus vite qu'un classifieur affiné ne peut être réentraîné.
Pour cette expérience, nous nous concentrons sur l'évaluation de la concordance de Jev avec nos prédictions de production/référence, qui sont basées sur des LLM. Nous attendons et observons un fort gain de débit en mode hors ligne avec Jev, nous rapportons donc la concordance comme un indicateur simple de qualité. Nous avons également établi une référence face à Laya, un modèle de décision à poids ouverts, ainsi qu'à un Laya affiné. Cet affinage s'est déroulé localement en quelques heures, et le modèle est également suffisamment petit pour être déployé sur une machine de développeur.
<div class="overflow-scroll" role="region" aria-label="Experiment results">
<table class="rich-text-table_component">
<thead class="rich-text-table_head">
<tr class="rich-text-table_row">
<th class="rich-text-table_header" scope="col">Expérience</th>
<th class="rich-text-table_header" scope="col">Concordance sur les grandes catégories de tâches</th>
<th class="rich-text-table_header" scope="col">Perf</th>
</tr>
</thead>
<tbody class="rich-text-table_body">
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Jev zero-shot</td>
<td class="rich-text-table_cell">66,8 %</td>
<td class="rich-text-table_cell">~12 min (concurrence de 4)</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Base Laya</td>
<td class="rich-text-table_cell">35,9 %</td>
<td class="rich-text-table_cell">~90 s (machine de développement locale)</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Laya affiné</td>
<td class="rich-text-table_cell">74,5 %</td>
<td class="rich-text-table_cell">~90 s (machine de développement locale)</td>
</tr>
</tbody>
</table>
</div>
En tant que modèle prêt à l'emploi, pratique et sans entraînement, Jev surpasse nettement Laya, mais, sans grande surprise, l'affinage fait briller Laya, en particulier au vu des chiffres de performance. Le compromis réside dans l'effort nécessaire pour obtenir de bonnes étiquettes et mettre en place l'entraînement. Jev reste probablement plus attractif lorsqu'une tâche est nouvelle ou que ses étiquettes évoluent.
Routage de modèles : transfert d'expert
I'll review the translation against the English original. Key observations: 1. The FR has an **extra opening paragraph** (about "routage de modèles") that corresponds to EN **part 1** content, not shown here. Since this is part 2/4, I need to check if the EN provided starts at "We used a simplified version..." — and the FR starts with an untranslated paragraph. This appears to be leftover context. However, the first EN `` shown IS "We used a simplified version..." The FR has an extra paragraph + figure (blog-1.webp) before it. This is likely intentional continuation overlap, but the EN shown doesn't include it. I should keep the FR aligned to EN provided.
2. **"Noul"** — In the EN, the term is "Pointwise Noul" and "Shared-state Noul". "Noul" is an unusual term (likely a product/technique name). In FR, "Pointwise Noul" → "Noul ponctuel" and "Shared-state Noul" → "Noul à état partagé". "Pointwise" is a technical term (pointwise ranking). Translating as "ponctuel" is acceptable.
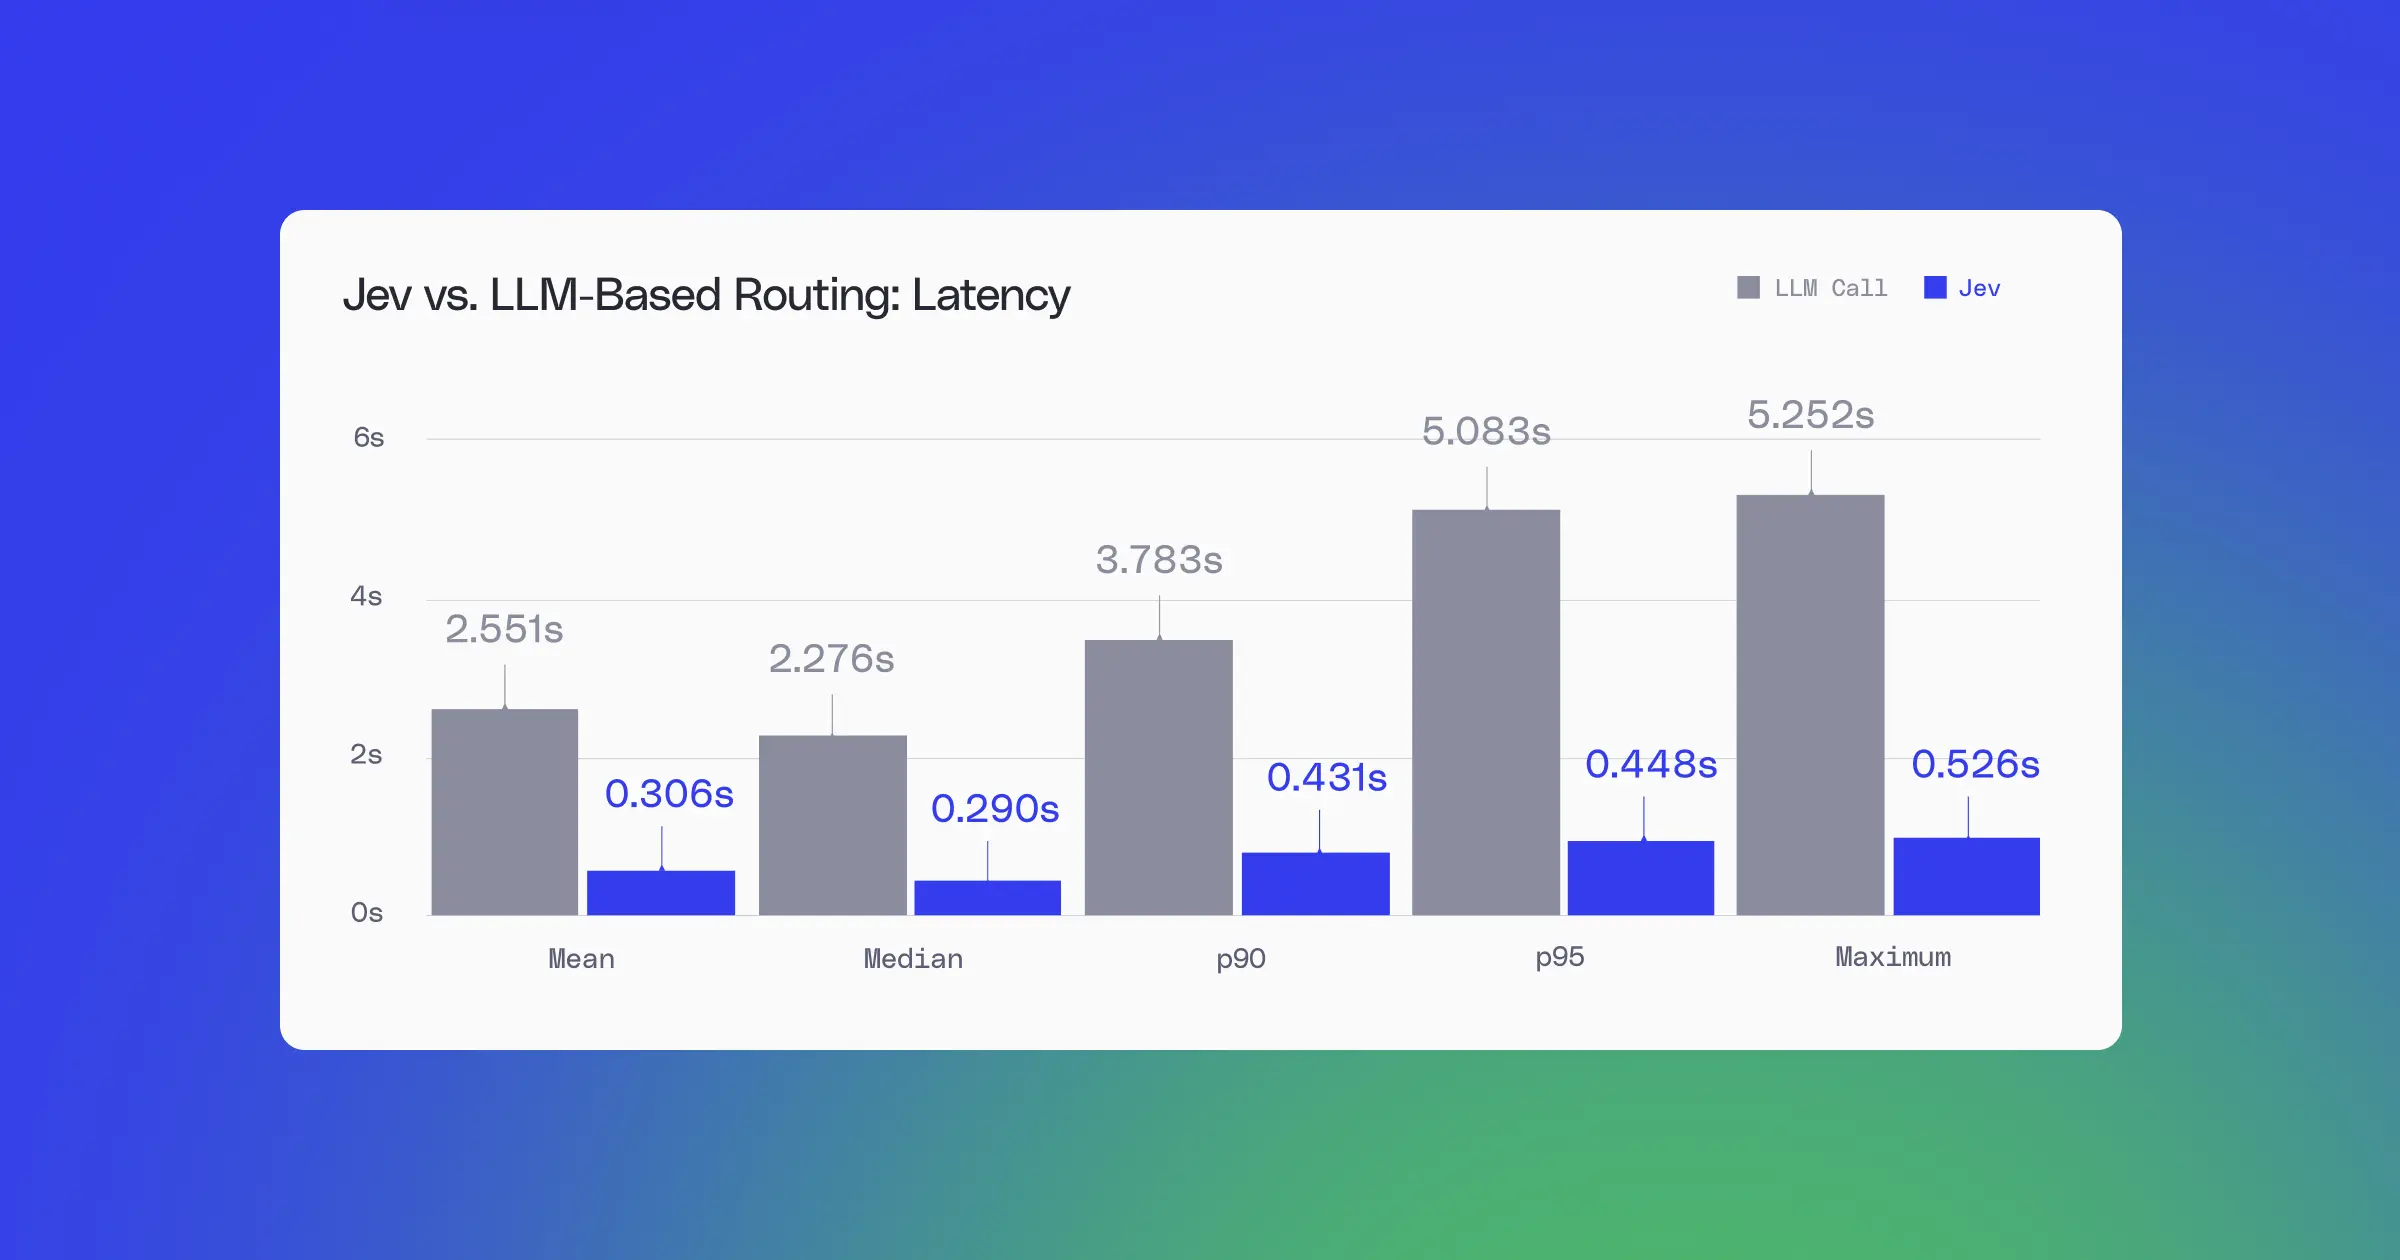
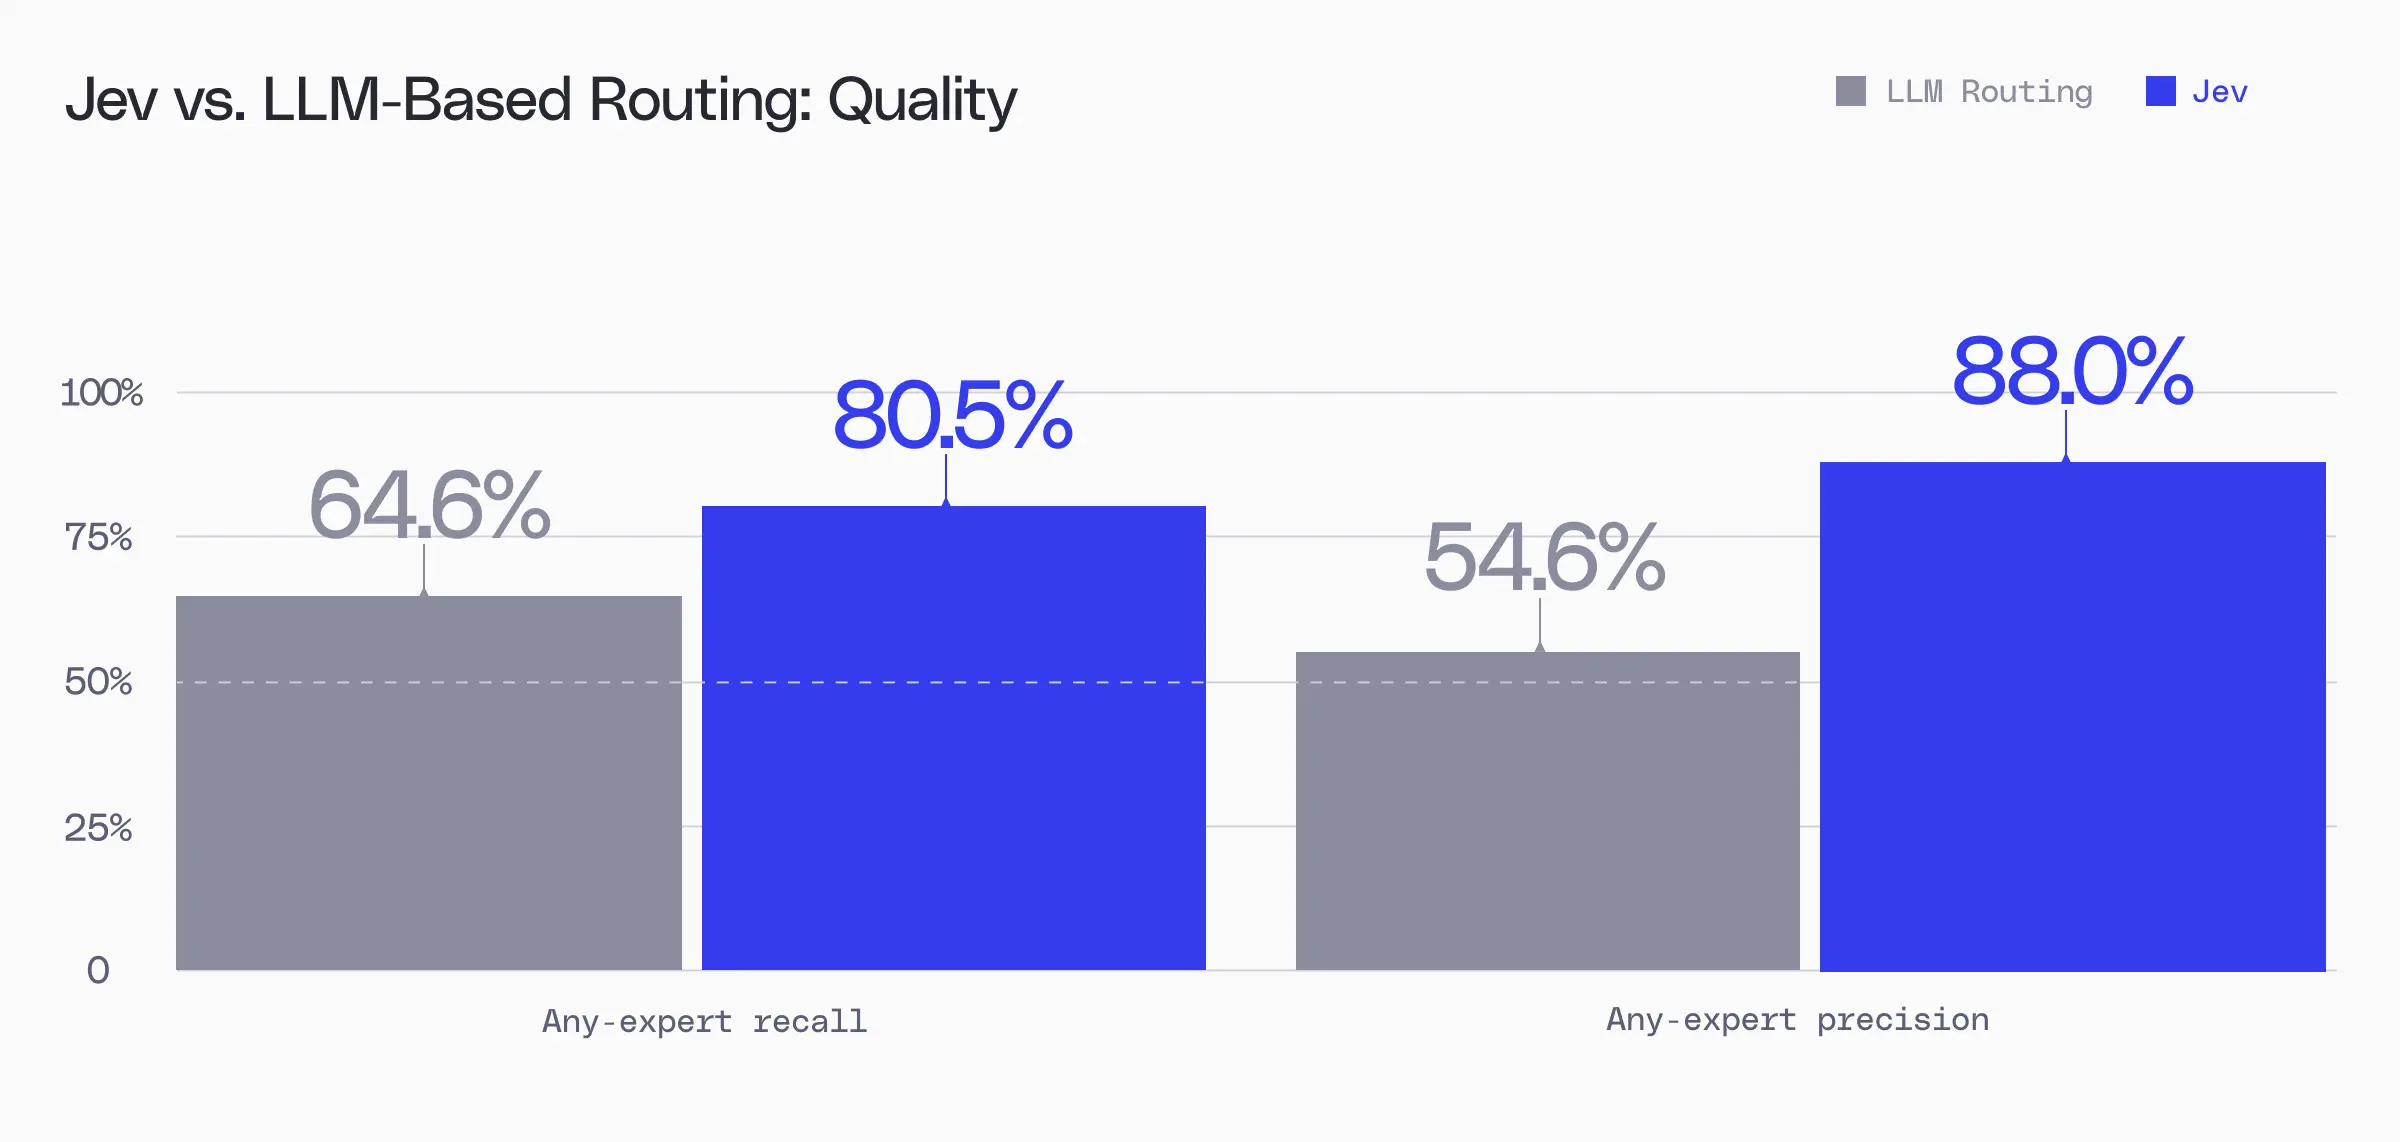
3. The **last figure** in EN has a full ` Le routage de modèles est un problème lié à la classification de requêtes. Ici, nous présentons le routage de modèles comme un transfert d'expert, où notre système choisit quel expert/modèle doit traiter la requête. Notre référence de production demande actuellement à un LLM de prendre cette décision nativement au sein de la boucle agentique du harness. Bien qu'il s'agisse d'un test naturel pour déterminer si Jev peut remplacer un appel génératif par une décision bornée, une limitation technique importante est que Jev ajoutera strictement un appel en cas de non-transfert. Cela contraste avec la référence de production, qui, dans les cas de non-transfert, peut commencer le travail d'appel d'outils via ce même premier appel unique au LLM. Nous avons utilisé une version simplifiée de notre routage de production avec seulement 3 experts, rejoué 751 entrées de référence comparables à travers le routeur Jev mis à jour, comparé la route qu'il a choisie avec notre routeur existant basé sur des prompts (alimenté par un LLM traditionnel), et mesuré la précision par rapport au label de référence. <div class="overflow-scroll" role="region" aria-label="Expert routing comparison"> L'accélération médiane par entrée était de 8,1×. Il s'agit de l'un des résultats internes les plus solides de Jev à ce jour : sur cette tâche de routage délimitée, Jev était à la fois plus précis et nettement plus rapide. L'ampleur de l'écart laisse penser que la « taxe de blocage » que nous subissons sur les requêtes non routées vers un expert pourrait être un bon compromis. Notez qu'il s'agit encore d'une comparaison hors ligne sur un golden set, et que l'échantillon de latence ne contient que 40 transferts positifs — il reste donc beaucoup à dérisquer et à tester ! Un problème qui tient à cœur à Glean ! Ci-dessous, notre référence de production est l'ordre produit par la pile de recherche existante de Glean. Cette expérience demandait ensuite à Jev de réordonner jusqu'à 50 résultats. Nous avons essayé quatre façons d'exprimer la pertinence à travers les sorties typées de Jev : <div class="overflow-scroll" role="region" aria-label="Relevance formulations"> Jev « Choix » était la formulation la plus solide. Sur un contrôle apparié de 4 855 requêtes de recherche capturées, avec le départage basé sur la production supprimé, le résultat était : <div class="overflow-scroll" role="region" aria-label="Ranker performance comparison"> L'évaluation des citations pose deux questions connexes : les affirmations nécessitant des preuves disposent-elles de citations adéquates (rappel des citations), et les sources citées étayent-elles réellement les affirmations qui leur sont attribuées (précision des citations) ? À première vue, parce que l'espace de sortie/d'étiquettes est borné (comme dans la plupart des configurations d'évaluation), cela semble parfaitement adapté à Jev. La grille d'évaluation est cependant complexe et peut nécessiter de décomposer plusieurs affirmations — de plus, Jev ne produit pas la justification que nous utilisons souvent pour l'analyse des erreurs, ce qui présente donc un certain risque pour la qualité comme pour l'utilisabilité. Nous avons testé Jev sur une véritable réponse d'évaluation de production de 1 448 mots, en maintenant fixes la réponse et les preuves de citation. Nous avons comparé sa passe partagée de précision et de rappel avec GPT-5.6 Luna sans raisonnement et avec un raisonnement xhigh. Pour réduire la variance, nous avons exécuté chaque évaluateur trois fois. <div class="overflow-scroll" role="region" aria-label="Judge time and cost"> Nous avons également comparé la cohérence sur les mêmes 28 paragraphes. Un élément modifié signifie que l'évaluateur a changé son verdict sur la question de savoir si un paragraphe disposait d'une couverture de citation adéquate dans au moins une des trois exécutions à entrées identiques. Le décompte des désaccords par paires compte chaque paragraphe sur les trois paires d'exécutions, soit 84 comparaisons par évaluateur. <div class="overflow-scroll" role="region" aria-label="Recall consistency comparison"> Nous ne concluons pas que cela fait de Jev l'évaluateur le plus précis (les systèmes appliquaient des critères de support et des dénominateurs de notation différents, et nous n'avons pas eu le temps de réaliser des annotations humaines indépendantes). Mais même avec un raisonnement xhigh (qui a environ triplé le temps de modèle de Luna), il est resté moins cohérent que Jev. Ce résultat conforte Jev comme un moyen rapide, peu coûteux et comparativement reproductible de mettre en œuvre une politique de citation restreinte. Nous n'en concluons pas pour autant que Jev est le juge le plus précis (les systèmes appliquaient des critères de support et des dénominateurs de notation différents, et nous n'avons pas eu le temps de réaliser des annotations humaines indépendantes). Mais même avec un raisonnement xhigh (qui a à peu près triplé le temps de traitement du modèle de Luna), il est resté moins cohérent que Jev. Ce résultat conforte Jev comme un moyen rapide, économique et relativement reproductible de mettre en œuvre une politique de citation restreinte. Dans certains cas, Jev se distingue comme une alternative sans friction tant aux LLM traditionnels qu'aux classificateurs affinés. Lorsque la référence est solide (reranking) ou qu'il est facile d'affiner un modèle plus petit (classification de requêtes), l'avantage est plus faible. On observe des signes d'une meilleure qualité pour certaines tâches (routage de modèles) ainsi que des indications d'une meilleure cohérence et stabilité (juge de citation). Pour certaines de nos charges de travail les plus importantes, il offre les gains attendus en matière de coût et de latence face aux LLM traditionnels. Les résultats ci-dessus fournissent de bonnes pistes directionnelles, et chez Glean, Jev nous enthousiasme beaucoup. Après quelques étapes supplémentaires (principalement la préparation opérationnelle, comme la résidence des données et les garanties), nous prévoyons de déployer Jev dans certains de ces cas d'usage. De plus, Jev jouera un grand rôle dans notre hackathon interne cette semaine et nous avons hâte de partager davantage de résultats ! Quelques conseils généraux pour conclure : si la sortie peut être listée à l'avance, testez Jev. Si la tâche et les labels sont stables et que le volume est élevé, testez aussi un classificateur affiné. Si l'appel doit générer une requête, une explication ou tout autre texte dynamique, gardez un modèle génératif dans la boucle. L'appel d'outils en est un bon exemple : Jev peut aider à choisir un outil, mais la plupart des outils Glean nécessitent encore des arguments générés dynamiquement (comme des requêtes de recherche). Jev ne change rien au fait que les classificateurs existaient déjà. Il rend simplement un bon classificateur zero-shot bien plus facile à utiliser. C'est un produit solide, même s'il ne constitue pas une nouvelle fondation pour chaque système d'IA. Auteurs : Eddie Zhou, Chau Tran, Aviral Singh, Matt Zhao, Manav Agrawal.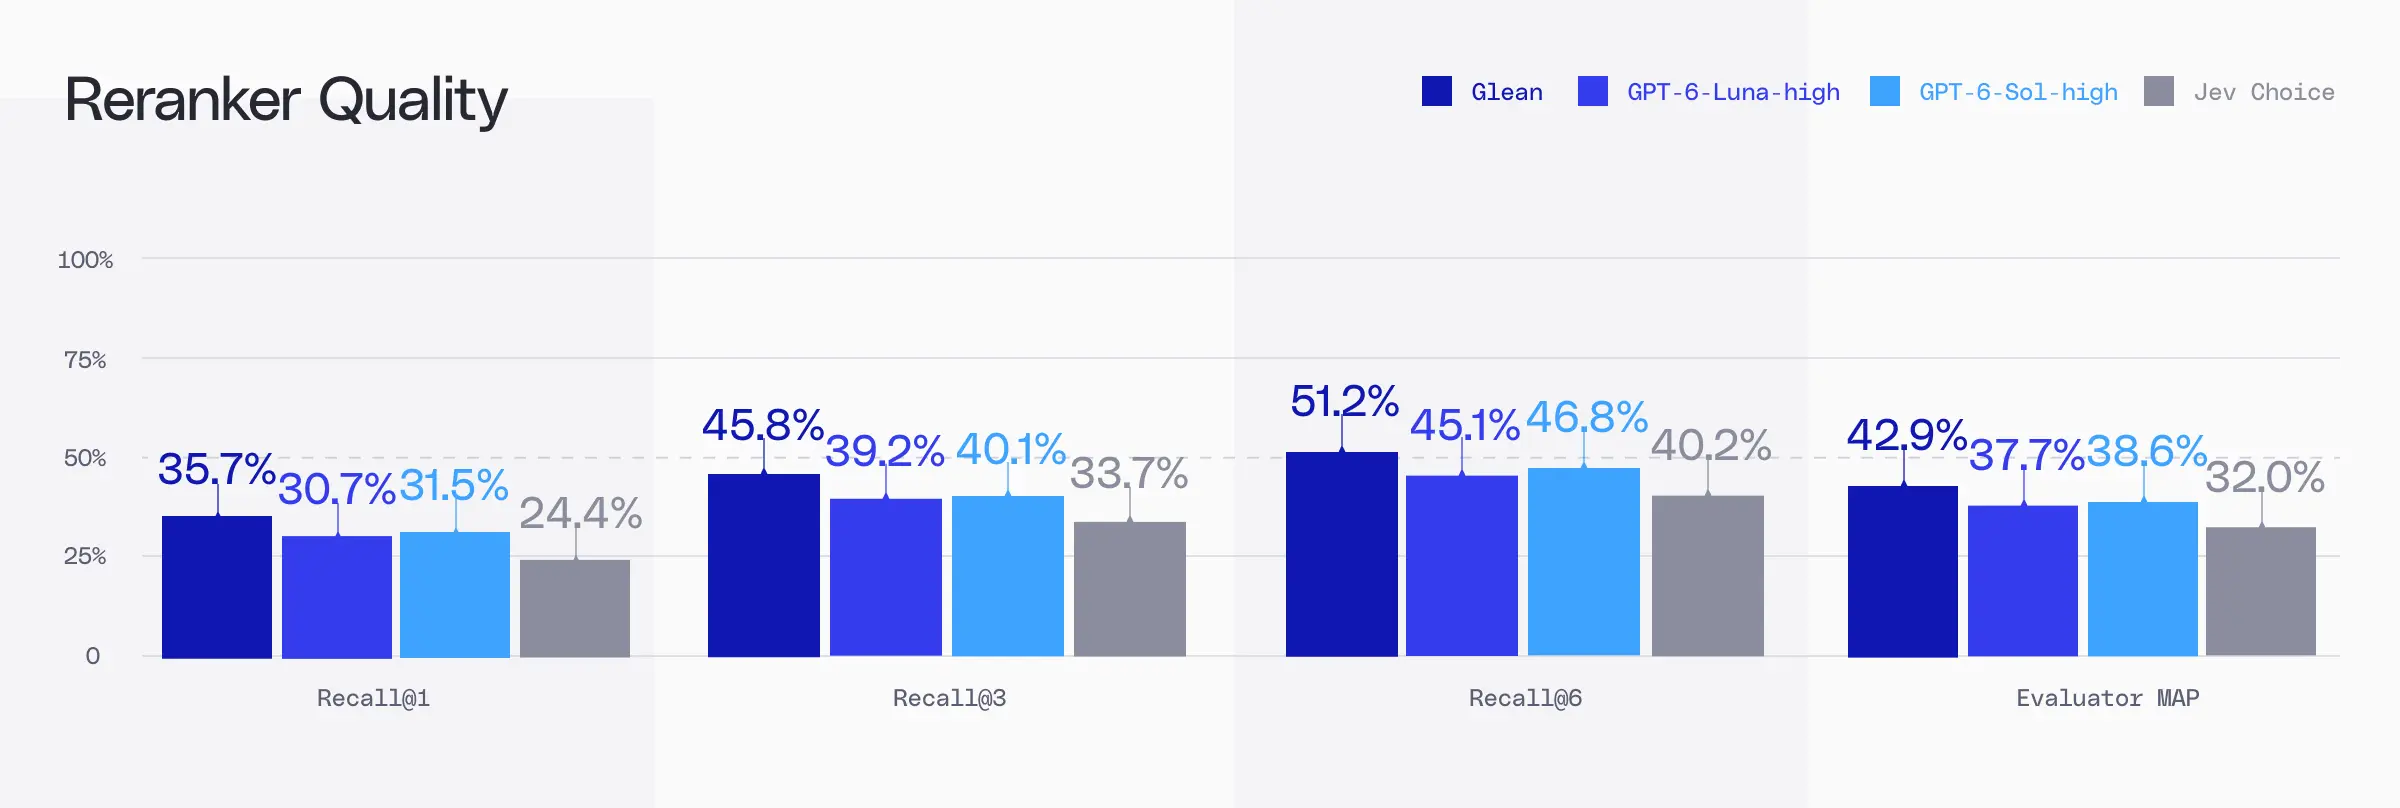
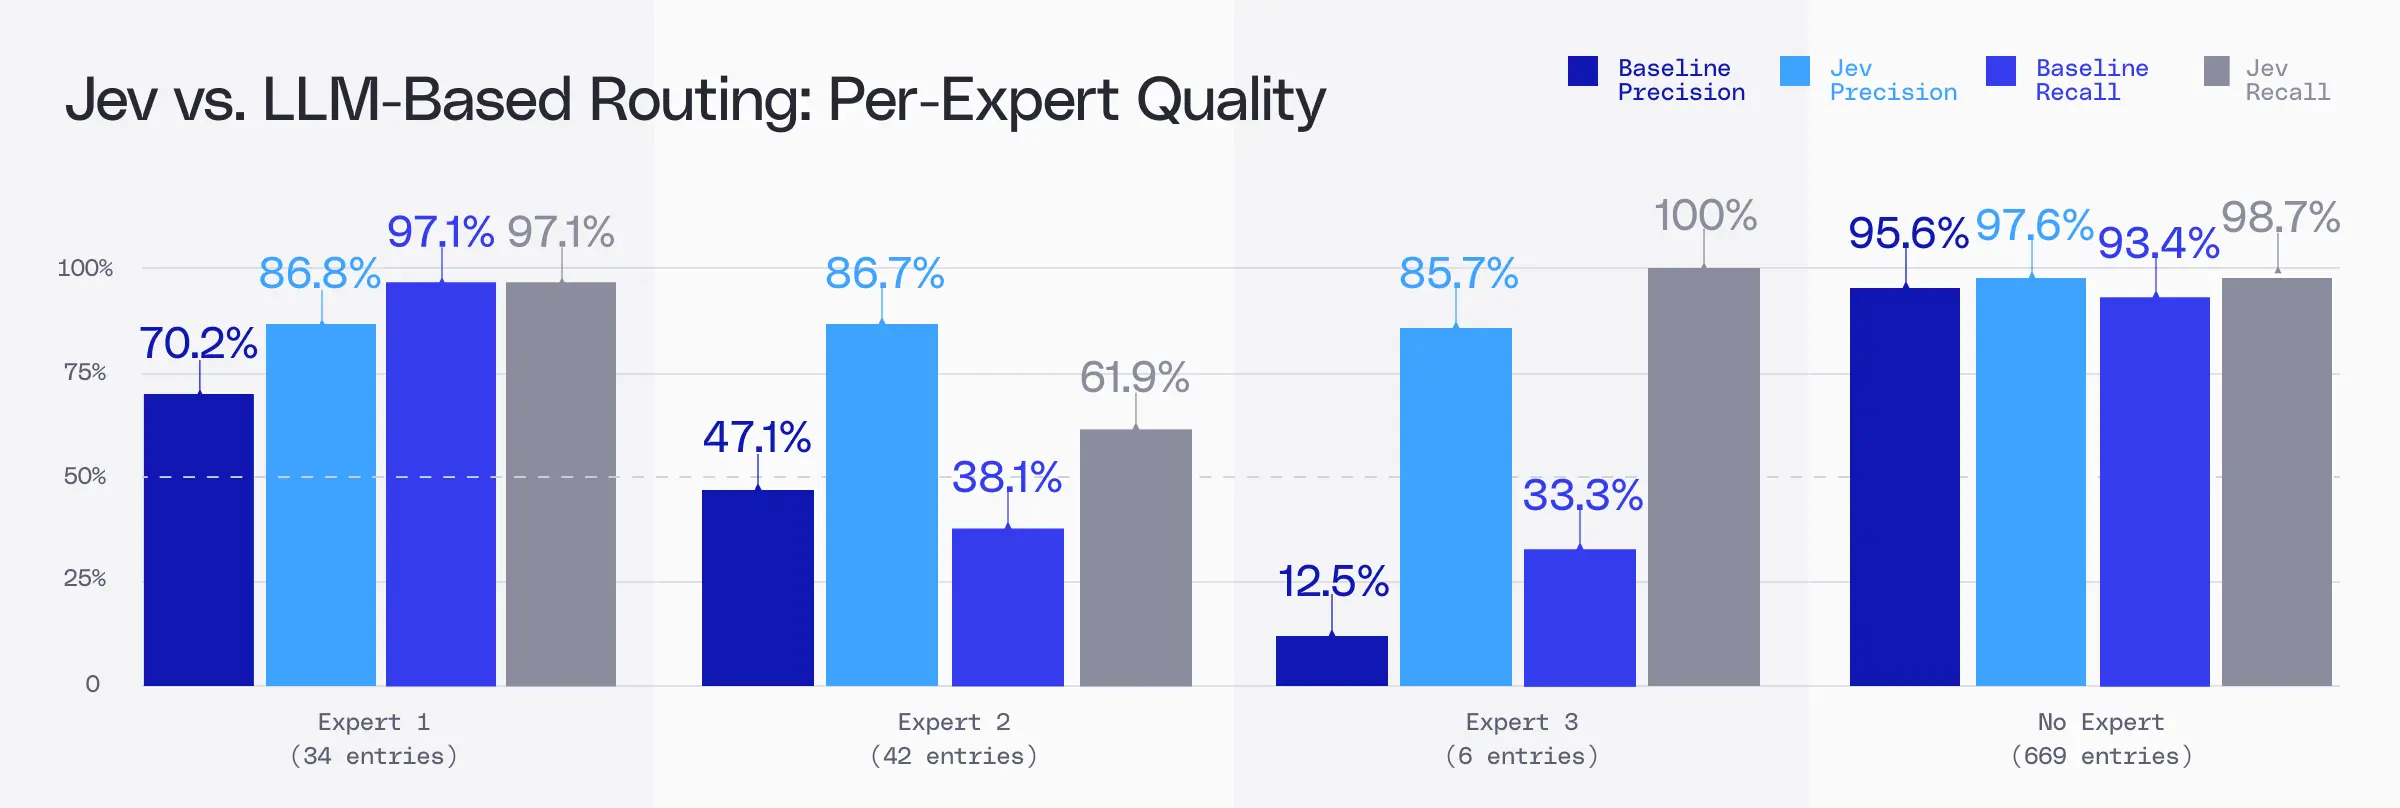
<table class="rich-text-table_component">
<thead class="rich-text-table_head">
<tr class="rich-text-table_row">
<th class="rich-text-table_header" scope="col">Route</th>
<th class="rich-text-table_header" scope="col">Entrées de référence</th>
<th class="rich-text-table_header" scope="col">Précision de référence</th>
<th class="rich-text-table_header" scope="col">Rappel de référence</th>
<th class="rich-text-table_header" scope="col">Précision de Jev</th>
<th class="rich-text-table_header" scope="col">Rappel de Jev</th>
</tr>
</thead>
<tbody class="rich-text-table_body">
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Expert 1</td>
<td class="rich-text-table_cell">34</td>
<td class="rich-text-table_cell">70,2 %</td>
<td class="rich-text-table_cell">97,1 %</td>
<td class="rich-text-table_cell">86,8 %</td>
<td class="rich-text-table_cell">97,1 %</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Expert 2</td>
<td class="rich-text-table_cell">42</td>
<td class="rich-text-table_cell">47,1 %</td>
<td class="rich-text-table_cell">38,1 %</td>
<td class="rich-text-table_cell">86,7 %</td>
<td class="rich-text-table_cell">61,9 %</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Expert 3</td>
<td class="rich-text-table_cell">6</td>
<td class="rich-text-table_cell">12,5 %</td>
<td class="rich-text-table_cell">33,3 %</td>
<td class="rich-text-table_cell">85,7 %</td>
<td class="rich-text-table_cell">100 %</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Aucun expert</td>
<td class="rich-text-table_cell">669</td>
<td class="rich-text-table_cell">95,6 %</td>
<td class="rich-text-table_cell">93,4 %</td>
<td class="rich-text-table_cell">97,6 %</td>
<td class="rich-text-table_cell">98,7 %</td>
</tr>
</tbody>
</table>
</div>
Nous avons également isolé 40 entrées pour lesquelles le chemin existant effectuait un véritable transfert vers un expert (n plus petit) et comparé la latence des appels sur ces mêmes entrées.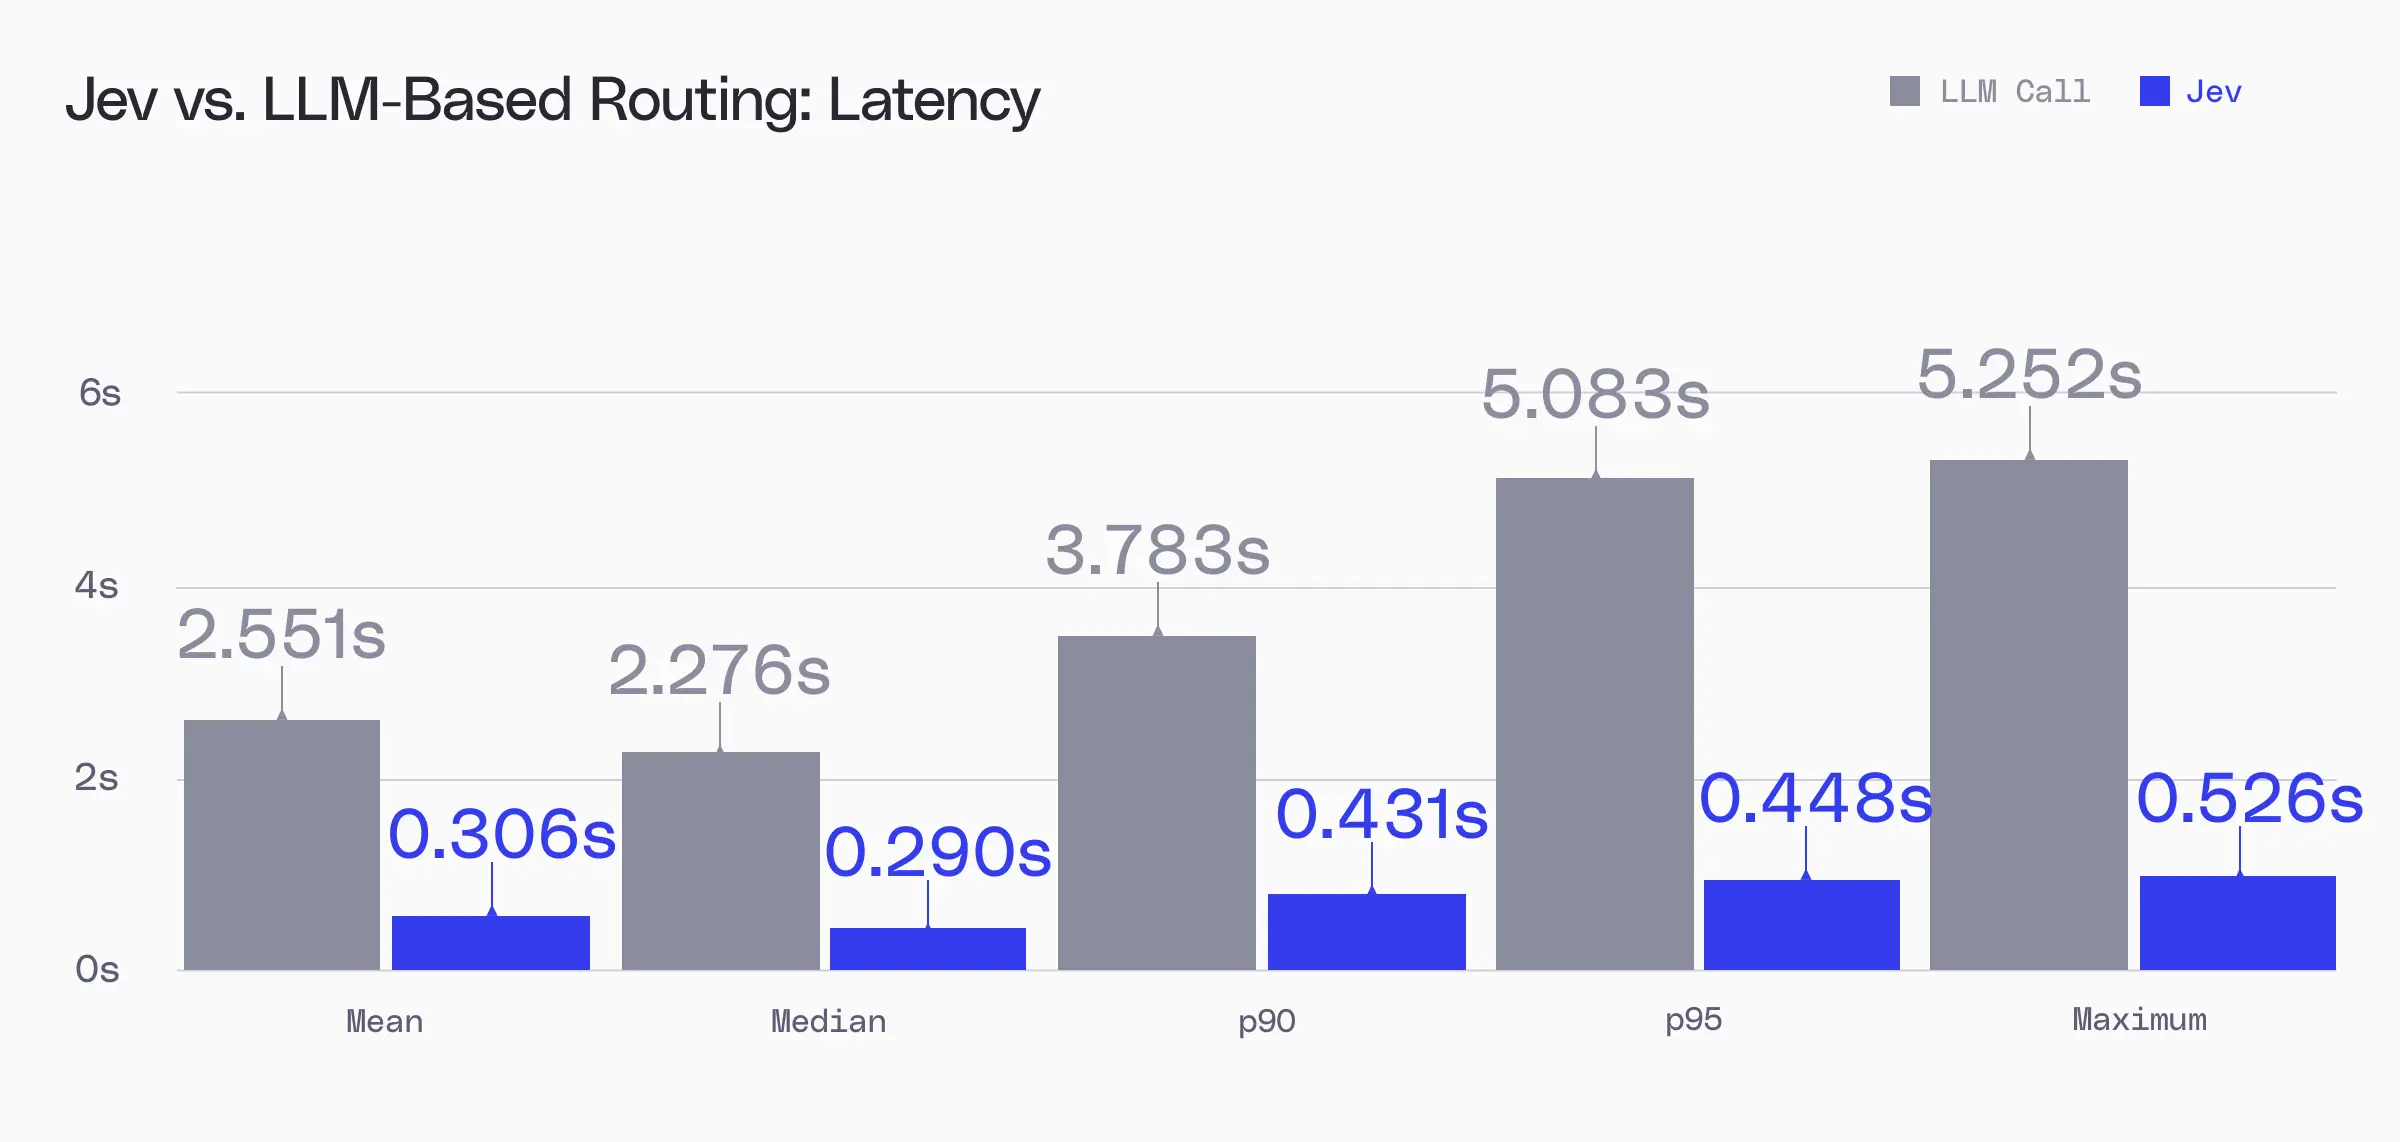
Reclassement
<table class="rich-text-table_component">
<thead class="rich-text-table_head">
<tr class="rich-text-table_row">
<th class="rich-text-table_header" scope="col">Formulation</th>
<th class="rich-text-table_header" scope="col">Comment elle exprime la pertinence</th>
</tr>
</thead>
<tbody class="rich-text-table_body">
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Noul ponctuel</td>
<td class="rich-text-table_cell">Poser une question de pertinence oui-ou-non distincte pour chaque résultat, puis trier selon la probabilité de « oui ».</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Noul à état partagé</td>
<td class="rich-text-table_cell">Montrer à Jev l'ensemble complet des candidats comme contexte partagé, puis poser la même question oui-ou-non pour chaque résultat.</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Score</td>
<td class="rich-text-table_cell">Demander à Jev d'attribuer à chaque candidat un score de pertinence numérique.</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Choix</td>
<td class="rich-text-table_cell">Traiter tous les candidats comme des alternatives au sein d'une seule décision, puis les classer selon les probabilités obtenues.</td>
</tr>
</tbody>
</table>
</div>
Nous avons exécuté cela sur un jeu d'évaluation interne où l'utilisateur n'a pas accès à tous les documents canoniques, de sorte que les chiffres absolus ne reflètent pas notre classement en production — mais les chiffres relatifs sont intéressants.
<table class="rich-text-table_component">
<thead class="rich-text-table_head">
<tr class="rich-text-table_row">
<th class="rich-text-table_header" scope="col">Ranker</th>
<th class="rich-text-table_header" scope="col">Recall@1</th>
<th class="rich-text-table_header" scope="col">Recall@3</th>
<th class="rich-text-table_header" scope="col">Recall@6</th>
<th class="rich-text-table_header" scope="col">MAP évaluateur</th>
</tr>
</thead>
<tbody class="rich-text-table_body">
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Ordre de production Glean existant</td>
<td class="rich-text-table_cell">35,74 %</td>
<td class="rich-text-table_cell">45,79 %</td>
<td class="rich-text-table_cell">51,18 %</td>
<td class="rich-text-table_cell">0,4289</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">GPT-6-Luna-high comme reranker</td>
<td class="rich-text-table_cell">30,71 %</td>
<td class="rich-text-table_cell">39,15 %</td>
<td class="rich-text-table_cell">45,08 %</td>
<td class="rich-text-table_cell">0,3766</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">GPT-6-Sol-high comme reranker</td>
<td class="rich-text-table_cell">31,54 %</td>
<td class="rich-text-table_cell">40,14 %</td>
<td class="rich-text-table_cell">46,84 %</td>
<td class="rich-text-table_cell">0,3862</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Jev Choice</td>
<td class="rich-text-table_cell">24,37 %</td>
<td class="rich-text-table_cell">33,72 %</td>
<td class="rich-text-table_cell">40,21 %</td>
<td class="rich-text-table_cell">0,3201</td>
</tr>
</tbody>
</table>
</div>
Jev Choice a coûté environ 0,00044 $ par requête et a mis 0,195 seconde au p50 lors du test hors ligne. Mais il a attribué des scores identiques à environ 37 des 41 candidats pour une requête moyenne. L'utilisation de l'ordre de production pour départager ces égalités a fait passer le Recall@6 de 40,2 % à 44,3 %, faisant paraître le résultat non corrigé plus solide que ce que les scores de Jev justifiaient à eux seuls. Il y a ici de nombreuses réserves, comme d'habitude, mais sur le plan directionnel, Jev est une référence peu coûteuse et efficace, et non un remplacement du ranker de production de Glean.Évaluation du support des citations
<table class="rich-text-table_component">
<thead class="rich-text-table_head">
<tr class="rich-text-table_row">
<th class="rich-text-table_header" scope="col">Évaluateur</th>
<th class="rich-text-table_header" scope="col">Temps initial mesuré par réponse</th>
<th class="rich-text-table_header" scope="col">Coût initial mesuré par réponse</th>
</tr>
</thead>
<tbody class="rich-text-table_body">
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Jev</td>
<td class="rich-text-table_cell">6,6 s</td>
<td class="rich-text-table_cell">0,014 $</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">GPT-5.6 Luna, sans raisonnement</td>
<td class="rich-text-table_cell">81,3–85,5 s</td>
<td class="rich-text-table_cell">0,030–0,047 $</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">GPT-5.6 Luna, xhigh</td>
<td class="rich-text-table_cell">227,4–259,7 s</td>
<td class="rich-text-table_cell">0,047–0,060 $</td>
</tr>
</tbody>
</table>
</div>
Notez que les durées sont directionnelles plutôt que de bout en bout : Jev rapporte le temps client séquentiel réel, tandis que les lignes Luna additionnent les durées des appels de modèle. Les coûts incluent la mise en cache observée.
<table class="rich-text-table_component">
<thead class="rich-text-table_head">
<tr class="rich-text-table_row">
<th class="rich-text-table_header" scope="col">Évaluateur</th>
<th class="rich-text-table_header" scope="col">Paragraphes avec un verdict de rappel modifié</th>
<th class="rich-text-table_header" scope="col">Désaccords de rappel par paires</th>
</tr>
</thead>
<tbody class="rich-text-table_body">
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">Jev</td>
<td class="rich-text-table_cell">1 sur 28 (3,6 %)</td>
<td class="rich-text-table_cell">2 sur 84 (2,4 %)</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">GPT-5.6 Luna, sans raisonnement</td>
<td class="rich-text-table_cell">7 sur 28 (25,0 %)</td>
<td class="rich-text-table_cell">15 sur 84 (17,9 %)</td>
</tr>
<tr class="rich-text-table_row">
<td class="rich-text-table_cell">GPT-5.6 Luna, xhigh</td>
<td class="rich-text-table_cell">5 sur 28 (17,9 %)</td>
<td class="rich-text-table_cell">10 sur 84 (11,9 %)</td>
</tr>
</tbody>
</table>
</div>
Le seul changement de Jev portait sur le fait qu'un paragraphe compte ou non comme nécessitant une citation ; sa catégorie de rappel brute n'a pas changé. Les verdicts de Jev sur la couverture de citation au niveau des paragraphes étaient donc plus reproductibles que l'une ou l'autre des configurations Luna.Enseignements de l'expérience et guide pratique
Le seul changement de Jev portait sur la question de savoir si un paragraphe comptait comme nécessitant une citation ; sa catégorie brute de rappel n'a pas changé. Les verdicts de couverture de citation au niveau des paragraphes de Jev étaient donc plus reproductibles que l'une ou l'autre des configurations de Luna.Enseignements de l'expérience et guide pratique
