Comment comparer les outils de gestion des connaissances pour améliorer le support client
Les équipes de support client font face à un défi constant : les connaissances nécessaires pour résoudre rapidement les problèmes se trouvent rarement au même endroit. Elles sont réparties entre centres d’aide, systèmes de ticketing, enregistrements CRM, wikis internes, fils de discussion, et documentation produit — dispersées d’une manière qui ralentit les agents et frustre les clients.
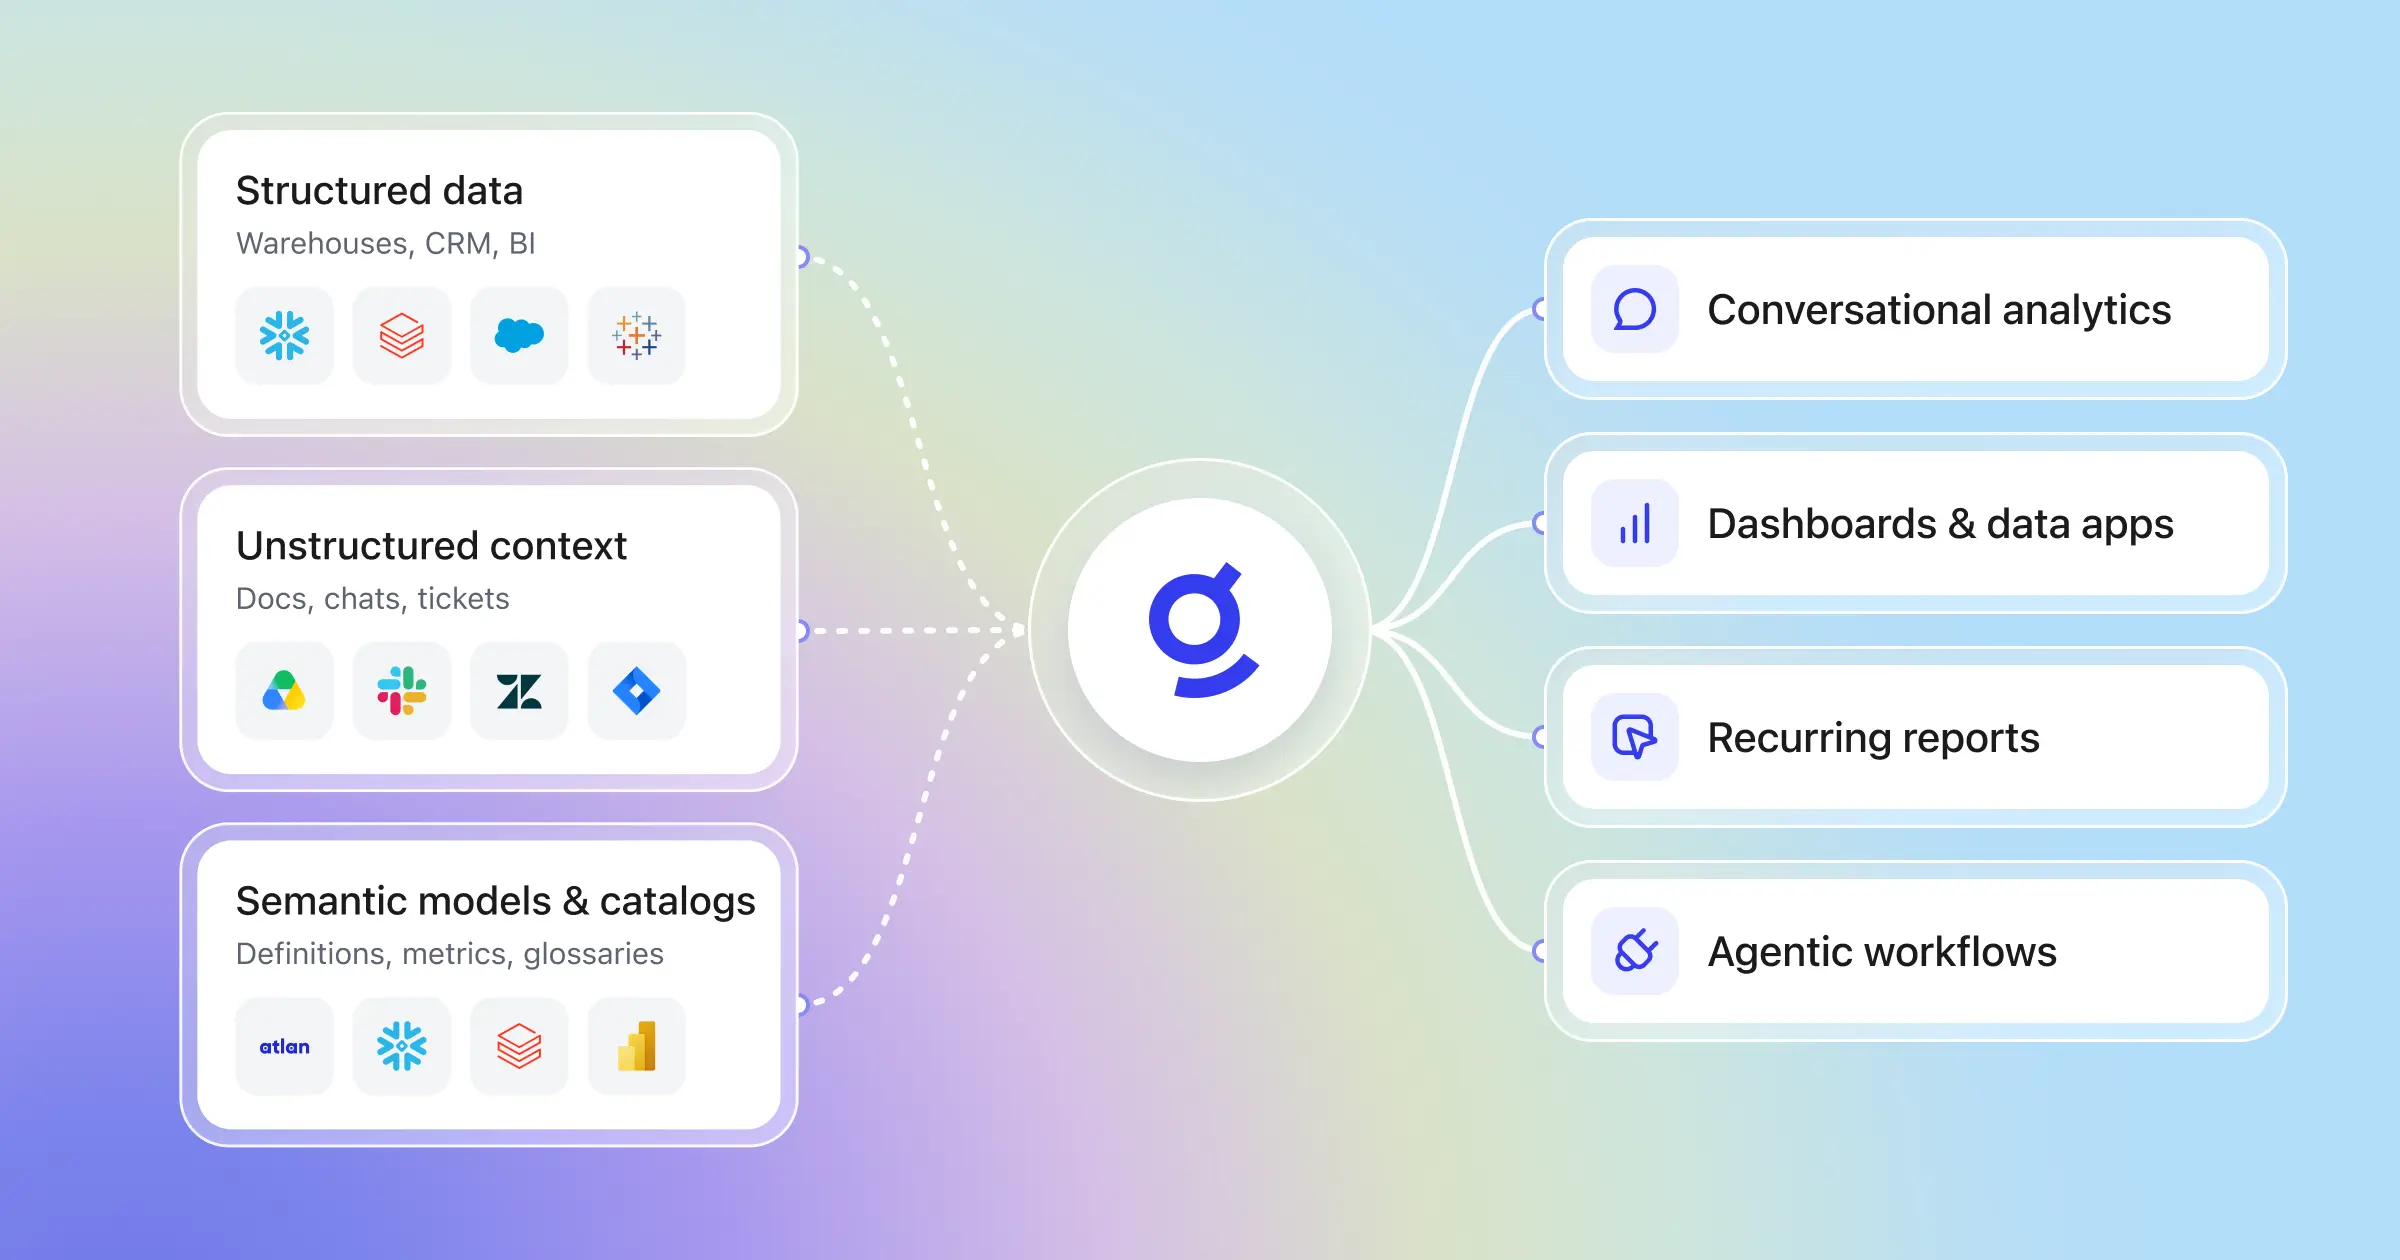
Une plateforme de découverte des connaissances s’attaque à ce problème à la racine. Plutôt que de demander aux équipes de tout consolider dans un référentiel unique, elle connecte des connaissances distribuées, comprend les questions en langage naturel et délivre des réponses fiables, respectant les permissions, là où le travail de support se déroule réellement.
Ce guide explique comment comparer des outils de gestion des connaissances conçus pour le support client — non pas par le nombre de fonctionnalités, mais par les résultats qui comptent : résolution plus rapide, self-service plus performant, meilleure gouvernance et amélioration mesurable de l’expérience client.
Qu’est-ce qu’une plateforme de découverte des connaissances pour le support client ?
Une plateforme de découverte des connaissances pour le support client est un système qui connecte l’information à travers les outils métier, comprend l’intention derrière une question, respecte les contrôles d’accès existants et fait remonter des réponses fiables, à la fois pour les agents et pour les clients. Elle va bien au-delà du simple stockage statique de documents. L’objectif principal est d’aider les équipes support à trouver, à faire confiance et à agir sur la bonne connaissance — rapidement — sans basculer entre une demi-douzaine d’applications ni s’appuyer sur une expertise « tribale » que seuls quelques agents seniors détiennent.
Les logiciels traditionnels de gestion des connaissances se concentrent généralement sur un centre d’aide unique ou un wiki interne. Les équipes publient des articles, les organisent en catégories, puis espèrent que la recherche par mots-clés fera le reste. Ce modèle atteint vite ses limites dans les environnements d’entreprise, où les réponses support s’étendent aux systèmes de ticketing, notes d’ingénierie, lecteurs partagés, journaux de modifications produit, playbooks d’escalade et données CRM. Une plateforme de découverte des connaissances agrège toutes ces sources, en traitant l’ensemble du paysage de connaissances de l’entreprise comme un système connecté plutôt que comme une collection de silos isolés.
Ce qui distingue la découverte du stockage
La distinction compte pour les opérations support au quotidien. Une base de connaissances IA de base stocke du contenu et renvoie des documents qui correspondent à une requête. Une plateforme de découverte fait quelque chose de fondamentalement différent :
- Recherche inter-systèmes : Elle indexe et recherche à travers les plateformes de connaissances de l’entreprise — help desks, outils de documentation, historique des discussions, wikis internes, et plus encore — pour que les agents n’aient pas à deviner où se trouve une réponse.
- Compréhension du langage naturel : Au lieu d’exiger des correspondances exactes de mots-clés, elle interprète les questions comme une personne les poserait. Un agent qui saisit « le client ne peut pas accéder au portail de facturation après la migration » devrait obtenir du contenu de dépannage pertinent, même si aucun article n’utilise exactement cette formulation.
- Réponses respectant les permissions : La plateforme réplique les permissions des sources en temps réel. Les agents ne voient que ce à quoi ils sont autorisés à accéder ; le self-service côté client ne fait remonter que le contenu public. Ce n’est pas optionnel pour les équipes enterprise — c’est fondamental.
- Réponses fondées, avec citations : Les réponses renvoient vers leurs sources, afin que les agents puissent vérifier l’exactitude avant de partager l’information avec un client. Le grounding réduit le risque d’hallucinations et construit le niveau de confiance qui favorise l’adoption.
- Pertinence contextuelle : Les meilleurs résultats tiennent compte de qui pose la question, de son rôle, de son équipe et de la situation — pas seulement de la similarité textuelle. Un ingénieur support et un spécialiste de la facturation peuvent poser la même question, mais avoir besoin de réponses différentes, issues de sources différentes.
Pourquoi cela compte spécifiquement pour les équipes support
Pour le support client, le bénéfice concret est direct. De meilleures fonctionnalités de découverte des connaissances se traduisent par une réduction du temps moyen de traitement, une hausse du taux de résolution dès le premier contact et une montée en compétence plus fluide pour les nouvelles recrues qui n’ont pas des années de contexte interne. Le self-service s’améliore parce que les clients trouvent des réponses exactes et à jour, au lieu de pages FAQ obsolètes qui créent plus de confusion qu’elles n’en résolvent.
La gestion de la documentation support passe aussi d’un processus manuel et réactif à un dispositif que la plateforme aide à maintenir. Lorsqu’un système de découverte suit quelles requêtes ne renvoient aucun résultat, quels articles conduisent à des résolutions réussies et quel contenu est devenu obsolète, les équipes knowledge peuvent prioriser les mises à jour en fonction d’un impact réel plutôt que d’estimations. Cette boucle de feedback — où les interactions support améliorent en continu la couche de connaissances — est ce qui distingue une plateforme de découverte moderne d’un référentiel statique qui se dégrade dès son lancement.
Comment choisir une plateforme de découverte des connaissances pour le support client ?
Choisissez une méthode de comparaison avant d’examiner le moindre produit. Une organisation support a besoin d’un système qui améliore les résultats de service au quotidien, pas d’un outil qui l’emporte par le volume de fonctionnalités ou un discours commercial bien rodé.
Ce changement transforme tout le processus d’achat. Au lieu de demander quelle plateforme offre le plus de capacités, demandez laquelle aide votre équipe à clôturer les dossiers avec moins de reprises, à servir les clients avec plus de cohérence, à garder les informations sensibles sous contrôle, à réduire l’entretien du contenu support et à montrer un gain opérationnel clair après le lancement.
Construire la grille d’évaluation autour des résultats métier
Une grille d’évaluation utile doit refléter les points de friction auxquels les équipes support sont confrontées chaque semaine. Gardez des catégories limitées, pratiques et directement liées à la performance du service :
- Vitesse de résolution des dossiers : Mesurez si les agents peuvent passer d’une question à une réponse validée avec moins de délais. Examinez la durée des dossiers, le volume de transferts et le temps nécessaire à une nouvelle recrue pour traiter les problèmes courants sans l’aide d’un senior.
- Qualité du self-service client : Évaluez si les clients trouvent la bonne réponse par eux-mêmes, si les résultats de recherche correspondent au langage réel, et si le système sait quand orienter un cas plus complexe vers une personne au lieu de mener à une impasse.
- Contrôle et gestion des risques : Examinez comment la plateforme gère les contenus restreints, l’accès au niveau de la source, les besoins d’audit et la traçabilité des réponses. Les équipes support ont besoin d’un système qui protège les notes internes, les exceptions de politique et les historiques d’escalade sans nécessiter une surveillance manuelle supplémentaire.
- Effort d’exploitation des connaissances : Vérifiez si le produit aide votre équipe à repérer les doublons, les articles faibles, les sujets sans réponse et les instructions obsolètes. C’est plus important que le nombre d’articles, car le contenu support évolue vite.
- Impact sur le service que vous pouvez prouver : Reliez l’évaluation à des indicateurs concrets tels que le taux de recontact, le taux d’escalade, la qualité de la première réponse, les sessions de self-service réussies et la confiance des agents dans les réponses qu’ils utilisent.
Un framework comme celui-ci donne à chaque équipe un langage commun pour l’évaluation. Il évite aussi une erreur fréquente : une plateforme peut sembler impressionnante lors d’une démo généraliste, tout en échouant sur le travail dont les équipes support ont le plus besoin.
Réunir la bonne équipe
Cette décision ne doit pas reposer uniquement sur les achats ou la direction du support. Les personnes au plus près du travail repèrent souvent les problèmes que les visites produit généralistes ne montrent pas : les agents en première ligne savent où les réponses se dégradent sous la pression du temps, les responsables de la connaissance savent où l’obsolescence des contenus crée du risque, et les responsables des opérations savent quelles lacunes de process ajoutent des coûts à grande échelle.
L’IT et la sécurité doivent être impliquées tôt, pas à la fin. Elles doivent tester la connectivité aux sources, les contrôles d’identité, la gestion des données et les contraintes de déploiement avant que la présélection ne se resserre. Cette revue en amont aide à éviter une surprise de dernière minute, lorsqu’un outil prometteur échoue à un contrôle de sécurité ou ne peut pas prendre en charge les systèmes sur lesquels vos agents s’appuient au quotidien.
Comparer chaque option selon les mêmes critères
Une fois que le groupe s’accorde sur la grille d’évaluation, appliquez-la sans exception. Donnez à chaque éditeur le même ensemble de scénarios de support, les mêmes sources d’exemple et les mêmes seuils de réussite. Testez les demandes courantes, les cas limites complexes, les recherches de politiques, et les situations où le bon résultat devrait être l’absence de réponse parce que l’utilisateur n’a pas l’accès.
Une bonne grille de pilote couvre généralement l’exactitude des réponses, l’autorité des sources, la clarté des réponses, la précision de la recherche, la fraîcheur de la synchronisation et la facilité d’usage dans le flux de travail du support. Demandez à chaque éditeur de montrer l’expérience produit exacte, pas une slide ou une maquette. Les tableaux de bord réels comptent aussi ; une plateforme doit révéler ce que les agents ne trouvent pas, ce que les clients abandonnent, et quelles lacunes de connaissance génèrent du travail répétitif.
Comme point de référence pratique, le guide de découverte de connaissances de Glean propose un benchmark clair de la qualité de retrieval en entreprise : une forte découvrabilité à travers les systèmes métiers, une gouvernance capable de résister aux contrôles d’entreprise, et des signaux d’usage qui montrent si la plateforme gagne la confiance après le déploiement.
1. Commencez par votre modèle de support et vos lacunes de connaissance
La comparaison des éditeurs doit commencer par la conception du service, pas par des catégories logicielles. Une plateforme adaptée à un help desk grand public à fort volume peut échouer dans une équipe support B2B qui gère de longs fils d’e-mails, des exceptions spécifiques à un compte et des escalades produit fréquentes.
Définir l’environnement de support
Documentez le modèle de support tel qu’il existe aujourd’hui : mix de canaux, complexité des dossiers, chemins de prise en charge et attentes en matière de niveaux de service. Notez où les demandes commencent, où elles changent de mains et quelles équipes façonnent la réponse finale — support, produit, finance, juridique ou ingénierie.
Une manière utile d’aborder cette étape est de découper l’environnement en quatre conditions opérationnelles :
- Mix de canaux : Séparez les canaux en direct des canaux asynchrones. Le chat et le téléphone exigent des réponses courtes et tranchées ; les cas par e-mail et en communauté nécessitent souvent plus de contexte, de détails de politique et de suivi.
- Profondeur des dossiers : Identifiez quelles demandes restent au support de première ligne et lesquelles nécessitent une revue par un spécialiste. Les réinitialisations de mot de passe et les vérifications de statut d’expédition requièrent un schéma de connaissance différent des litiges de facturation ou des échecs d’intégration.
- Points d’approbation : Repérez chaque moment où un agent ne peut pas répondre sans validation d’une autre équipe. Ces transferts révèlent souvent là où la connaissance manque de structure ou là où les règles d’exception vivent en dehors de la documentation formelle.
- Niveaux d’audience : Séparez le contenu d’aide public, les consignes opérationnelles réservées aux agents et le contenu d’exception à accès restreint en classes distinctes. Chaque classe a besoin de ses propres règles de retrieval, de son propre modèle de revue et de son propre format de réponse.
Cet exercice rend l’évaluation plus précise. Certaines plateformes conviennent à la recherche dans une FAQ ; d’autres sont adaptées à l’interprétation de politiques, au dépannage guidé ou au traitement de dossiers inter-équipes.
Trouver les questions qui révèlent les vrais écarts
Ensuite, extrayez un échantillon de dossiers récents qui ont pris trop de temps, ont rebondi entre équipes ou ont produit des réponses incohérentes. Utilisez du trafic support réel du dernier trimestre — pas des exemples sélectionnés dans des decks d’enablement.
Regroupez ces dossiers par type de question. Dans la plupart des équipes entreprise, un petit nombre de schémas génère une grande part des frictions :
- Interprétation de politiques : Les conditions de remboursement, de renouvellement, les crédits de service et les vérifications d’éligibilité se dégradent souvent lorsque les agents doivent concilier plusieurs versions d’une même règle.
- Triage diagnostique : Les problèmes produit correspondent rarement à un seul article. Les agents ont besoin, dans un même parcours, des détails d’erreur, du contexte des incidents connus, des notes de contournement et de l’historique des dossiers précédents.
- Questions liées à l’état du compte : Le statut de configuration, les retards de provisioning, les problèmes d’accès utilisateur et les vérifications de l’état de facturation dépendent souvent de champs CRM, de notes d’administration et de données produit, plutôt que du seul texte des articles.
- Explication des changements : Les lancements produit, les dépréciations et les suivis d’incident exigent des agents qu’ils expliquent ce qui a changé, qui est impacté et quelle action le client doit entreprendre.
- Gestion des exceptions : Les cas les plus difficiles se situent en dehors du script standard. Les crédits hors politique, les conditions spécifiques à une région ou les comportements de contrat personnalisés exposent souvent là où l’expertise n’a pas de lieu durable.
Ces catégories révèlent les points de défaillance réels : dérive des versions, faible précision de recherche, absence de responsable, couverture d’articles insuffisante ou dépendance excessive à la mémoire des profils seniors. L’objectif n’est pas un inventaire de contenu plus long ; l’objectif est une vision plus claire des endroits où le travail du support ralentit parce que le parcours de réponse se casse.
Établir une base avant la revue des éditeurs
Cartographiez les workflows qui consomment le plus d’effort et portent le plus de risque client. Des exemples courants incluent la revue des remboursements, la mise en place de compte, le dépannage d’intégration, la communication des changements produit et le transfert vers les ingénieurs après l’impact d’un incident.
Puis capturez un état de référence avec des métriques opérationnelles liées à ces workflows. Le temps moyen de traitement et la résolution au premier contact restent importants, mais ils racontent rarement toute l’histoire à eux seuls. Ajoutez le taux de succès de recherche, le taux de reformulation des requêtes, le taux de requêtes sans résultat, le taux de transfert, le délai d’escalade, la résolution en self-service par type de problème, et le nombre de jours avant qu’un nouvel agent puisse clôturer des dossiers courants sans l’aide d’un collègue senior.
Cette base donne de la rigueur à la comparaison. Une démo éditeur peut rendre n’importe quelle interface élégante ; un test de workflow mesuré montre si la plateforme réduit les contacts répétés, raccourcit les parcours de réponse et diminue la part du travail support qui stagne dans les files de revue.
2. Cartographier les systèmes auxquels la plateforme doit se connecter
Traitez la cartographie des sources comme un exercice opérationnel, pas comme une visite produit. Le support s’appuie sur un noyau de systèmes pour le traitement des tickets en direct et sur une seconde couche pour le contexte de politique, de produit et de compte ; la plateforme doit fonctionner avec cette pile telle qu’elle existe aujourd’hui.
Gardez un périmètre discipliné. Constituez un inventaire des sources, classez chaque système selon sa valeur pour le support, puis testez la plateforme par rapport à cette liste dans le même ordre que celui dans lequel les agents utilisent ces systèmes pendant un ticket. Cela permet de garder l’évaluation ancrée dans les outils de support client dont votre équipe dépend déjà.
Classer les sources par valeur pour le support
Toutes les sources ne méritent pas le même poids. Un centre d’aide public peut répondre aux questions courantes de configuration, mais une règle de facturation dans le CRM ou une note de défaut dans un système d’ingénierie peut déterminer si un agent peut résoudre le ticket correctement.
Utilisez trois niveaux pour trier la pile :
- Sources de première ligne : enregistrements de tickets, historique de chat, macros et runbooks internes que les agents consultent pendant les tickets actifs.
- Sources de décision : champs CRM, documents de politique, conditions contractuelles, enregistrements de facturation, notes de version et mises à jour de l’état du service qui définissent ce qu’un agent peut dire ou faire.
- Sources d’escalade : revues d’incidents, outils de suivi des défauts, documentation d’ingénierie et notes de spécialistes qui couvrent les problèmes inhabituels ou à haut risque.
Ce modèle structure la comparaison. Il met aussi en évidence tôt une faiblesse fréquente : certaines plateformes gèrent bien les articles publiés, puis perdent en profondeur dès qu’une question dépend d’enregistrements opérationnels ou de contexte spécialiste.
Regarder au-delà du nombre de connecteurs
Le volume de connecteurs peut masquer une couverture superficielle. Une intégration utile doit préserver le contexte des fils de discussion, la structure des documents, la propriété des sources, les dates, les tags et les règles d’accès ; sans ces signaux, la qualité de recherche se dégrade rapidement.
Passez en revue chaque source prioritaire à un niveau technique :
- Fréquence de synchronisation : le support a besoin de données à jour pour les pannes, les changements de politique et les tickets récemment clôturés.
- Types de contenu indexés : les corps d’articles seuls ne suffisent pas ; les commentaires, pièces jointes, PDF, feuilles de calcul, transcriptions et présentations comptent aussi.
- Conservation des métadonnées : la gamme produit, la sévérité, la région, le niveau de client et le statut du document façonnent souvent la bonne réponse.
- Comportement de mise à jour : les modifications, suppressions et changements d’accès doivent se répercuter sans nettoyage manuel.
- Fidélité des permissions : la plateforme doit respecter les règles de visibilité déjà en place dans chaque système source.
C’est là qu’un logiciel de gestion des connaissances solide se distingue d’une couche de recherche basique. La couverture large compte, mais la profondeur d’intégration détermine si la réponse reste fiable.
Évaluer la compréhension des relations
Les tickets de support reposent rarement sur un seul enregistrement pris isolément. Une réponse solide peut nécessiter l’historique du ticket, les détails de l’offre du client, un changement récent de produit et l’équipe propriétaire du sujet. La plateforme doit comprendre ces relations au lieu de traiter chaque fichier comme un résultat déconnecté.
Testez cela avec des scénarios réels issus de votre file. Une exception de remboursement peut nécessiter le texte de la politique, les conditions contractuelles et une note interne de la finance. Un problème d’accès au compte peut dépendre des paramètres d’identité, d’un incident de service et du dernier contournement proposé par l’ingénierie. Des plateformes comme Glean modélisent ces liens entre personnes, contenus, conversations et tâches, ce qui offre aux équipes enterprise une couche de découverte de connaissances plus fiable qu’un système construit autour de documents autonomes uniquement.
3. Comparer les fonctionnalités de recherche et de découverte des connaissances
Après la couverture des systèmes vient le test le plus difficile : savoir si la plateforme peut transformer des données enterprise désordonnées en une réponse de support fiable. C’est là que les écarts les plus importants apparaissent, car les équipes support ne travaillent pas uniquement à partir de bibliothèques d’articles propres. Elles travaillent à partir de courts échanges de chat, de notes de tickets, de pages de politique, de fils de bugs, de mises à jour de version, de feuilles de calcul et de documents internes dont le format, la qualité et la longueur varient fortement.
Ce mélange de données met rapidement en évidence une récupération faible. Une plateforme peut sembler capable en démo, puis s’effondrer dès qu’un agent cherche un acronyme à moitié oublié, un nom de code produit ou une exception de politique enfouie dans un fil de commentaires. De solides fonctionnalités de découverte des connaissances prennent cette réalité en compte dès le départ.
Rechercher une récupération hybride, pas une seule méthode de recherche
Le support enterprise a besoin de plus d’un type de recherche. La récupération par correspondance exacte reste importante, car le travail de support repose sur des termes spécifiques — codes d’erreur, feature flags, noms d’abonnements, libellés de files internes et langage contractuel. Dans le même temps, les agents recherchent souvent en langage courant, surtout sous pression, et le système doit comprendre cette formulation sans correspondance parfaite des mots-clés.
Les plateformes les plus solides combinent plusieurs méthodes au sein d’une seule couche de récupération :
- Récupération lexicale : elle gère les chaînes exactes avec précision. Elle compte le plus pour les contenus enterprise courts, où un terme produit ou un identifiant peut changer complètement la réponse.
- Récupération sémantique : elle gère l’intention et la paraphrase. Elle aide lorsqu’un utilisateur demande la réponse en langage courant alors que les sources utilisent un langage de documentation formel.
- Planification de requête : elle réécrit la recherche avant que la récupération ne commence. En pratique, cela peut signifier l’expansion d’abréviations, d’alias produit, d’acronymes internes ou de terminologie support afin que le système cherche ce que l’utilisateur voulait dire, pas seulement ce qu’il a tapé.
Cela compte parce que les données enterprise se comportent rarement comme du contenu web. Une réponse Slack n’a pas de titre ; une note de troubleshooting peut se trouver dans un ticket privé ; une mise à jour produit peut apparaître dans un changelog sans aucun cadrage support. La récupération hybride donne à la plateforme de meilleures chances de trouver la bonne source sur ce terrain irrégulier.
Demander comment la pertinence fonctionne en pratique
La qualité de recherche dépend moins du volume de récupération que de la discipline de classement. En support, le meilleur résultat n’est souvent pas le document dont le libellé est le plus proche. C’est la source actuelle, approuvée, sûre pour le support, qui correspond au ticket et reflète la manière dont l’entreprise fonctionne réellement.
Demandez aux fournisseurs ce qui détermine l’ordre de classement, et demandez des exemples concrets. Une réponse utile doit expliquer pourquoi un runbook d’escalade actuel bat un ancien contournement, pourquoi une note interne validée surclasse une mention informelle dans un chat, et comment le système traite les réponses en doublon à travers différents référentiels.
Trois signaux de classement méritent un examen attentif :
- Autorité et propriété : le moteur doit privilégier les sources approuvées, les contenus maintenus et les éléments rattachés à la bonne équipe ou au bon propriétaire de processus. Cela réduit les réponses provenant de copies non officielles ou de documents annexes obsolètes.
- Fraîcheur avec contexte : Le contenu récent n’est pas toujours meilleur, mais des consignes de support obsolètes créent du risque. Les bons systèmes pondèrent la récence d’une manière adaptée à la source — les mises à jour d’incidents exigent une fraîcheur très élevée ; les documents de politique « evergreen » doivent conserver un classement stable jusqu’à ce qu’une nouvelle version les remplace.
- Adaptation au langage de l’entreprise : Le support en entreprise fonctionne avec un vocabulaire interne. Les noms de code des produits, les noms de files, les abréviations et le jargon du support façonnent tous le sens des requêtes. Les plateformes qui s’adaptent au langage propre à l’entreprise tendent à améliorer la qualité de la recherche au fil du temps, car elles apprennent comment les équipes décrivent réellement le travail.
Évaluez l’expérience de réponse, pas seulement la liste de résultats
Les agents support ont rarement besoin d’une pile de liens et d’une intuition. Ils ont besoin d’un système capable de composer la réponse à partir des bonnes preuves, de préserver le contexte au fil des questions de suivi, et de réduire la quantité de synthèse manuelle requise pendant un dossier en cours.
C’est là que la conception de la réponse compte. Comparez la manière dont chaque plateforme gère le passage de la recherche à la réponse :
- Preuves au niveau du passage : Le système doit indiquer l’extrait exact, le champ ou la note qui étaye la réponse. Cela fait gagner du temps et rend la vérification bien plus facile qu’une référence générique à un document.
- Continuité des questions de suivi : Le support en plusieurs étapes commence souvent large, puis se resserre rapidement. La plateforme doit conserver le contexte tout au long de l’échange afin que l’agent puisse affiner la demande sans repartir de zéro.
- Synthèse multi-sources : De nombreuses réponses de support nécessitent plus d’une source — un document de politique, une note d’incident récente et une mise à jour produit, par exemple. Les systèmes performants peuvent assembler ces entrées sans aplanir les différences importantes entre elles.
- Découverte d’expertise : Certains dossiers nécessitent un jugement humain. La plateforme doit aider à faire remonter la bonne équipe, le bon owner ou l’expert métier lorsque la réponse dépend de connaissances spécialisées plutôt que de documentation publiée.
Cette partie de l’évaluation révèle généralement si un produit peut prendre en charge un vrai dépannage ou seulement une recherche basique. Une plateforme qui gère les preuves au niveau du passage, le contexte multi-tours et l’orientation vers les experts sera nettement plus utile dans des files où les dossiers couvrent le comportement du produit, l’historique du compte et les règles de processus internes.
Considérez la recherche tenant compte des permissions comme une composante de la qualité de recherche
Les contrôles de permissions ne jouent pas seulement sur l’accès. Ils déterminent aussi si la réponse elle-même peut être jugée fiable. En support, le contenu restreint se trouve souvent à côté du contenu public — des notes internes rattachées à un dossier client, des exceptions financières liées à un article de facturation, ou des consignes d’escalade qui ne doivent jamais apparaître en self-service.
Cela signifie que les tests de recherche doivent aller au-delà de simples vérifications de visibilité. Regardez comment la plateforme se comporte dans des cas limites :
- Scénarios d’accès partiel : Peut-elle exclure des sections restreintes à l’intérieur d’une source largement visible, ou traite-t-elle l’élément entier comme une seule unité ?
- Réponses à sources mixtes : Lorsqu’une réponse s’appuie à la fois sur des éléments publics et privés, supprime-t-elle proprement la partie restreinte ?
- Variations selon les rôles : La réponse et les preuves associées changent-elles correctement pour un agent de première ligne, un spécialiste et une expérience d’aide orientée client ?
- Cas de recherche négatifs : Lorsqu’un utilisateur n’a pas accès, la plateforme doit ne renvoyer aucune réponse plutôt qu’un résumé non sûr basé sur du contenu masqué.
C’est l’un des tests pilotes les plus pratiques qu’une équipe support puisse mener. Il montre si la couche de recherche respecte les frontières de l’entreprise en conditions réelles, et pas seulement dans des slides produit.
Distinguez la substance du packaging IA
De nombreux éditeurs mettent en avant un discours d’assistant, mais l’interface n’est que la surface. Les questions les plus utiles se trouvent en dessous : comment la plateforme planifie une requête, comment elle récupère des preuves, comment elle génère la réponse et comment elle contrôle la qualité après l’affichage de la réponse.
Demandez si le produit s’appuie principalement sur une base de données vectorielle et un grand modèle de langage, ou s’il inclut des contrôles de recherche plus solides comme la réécriture de requêtes, un classement tenant compte des sources, la sélection de preuves et l’évaluation des réponses. Dans des environnements de support réels, ces détails influencent la fiabilité bien plus que l’étiquette collée au chatbot.
Les produits les plus solides peuvent aussi expliquer comment ils évaluent la qualité des réponses. Cherchez des indices montrant que l’éditeur mesure la qualité de la recherche et de la réponse comme deux problèmes distincts, suit les recherches infructueuses et surveille les cas où le système renvoie des réponses de support incomplètes ou faibles. Ce niveau de rigueur en dit généralement plus sur l’adéquation à long terme que de grandes promesses IA ne le feront jamais.
4. Évaluez à quel point cela aide les agents dans le flux de travail
À ce stade, la comparaison doit passer de la seule recherche à l’exécution des dossiers. Une plateforme solide doit réduire la distance entre la prise en charge et la résolution, au sein même de l’espace de travail de l’agent.
Les meilleurs produits agissent comme une couche de support active, pas comme une étagère de documents avec une boîte de chat par-dessus. Ils doivent transformer les données de dossiers en cours en actions de support exploitables — une synthèse claire du problème, un chemin de résolution probable, un brouillon de réponse et les preuves dont un agent a besoin avant d’envoyer quoi que ce soit ou d’escalader.
Recherchez une assistance qui réduit le travail par dossier
Une démo produit donne souvent l’impression que chaque interaction est simple. Le support réel est plus chaotique : longs échanges, informations client partielles, politiques de cas limites et étapes internes qui varient selon les équipes.
Comparez chaque plateforme sur des tâches que les agents répètent toute la journée :
- Aide à la prise en charge du dossier : Le système doit condenser une longue chaîne d’e-mails, une transcription de chat ou un fil de ticket en un court énoncé du problème, avec les faits clés mis en avant. Cela fait gagner plusieurs minutes au début de chaque dossier et réduit le risque de passer à côté d’un détail.
- Préparation des réponses : Recherchez des brouillons modifiables pour les réponses aux clients, les notes internes et les messages d’escalade. Le test utile n’est pas de savoir si le système peut rédiger du texte ; c’est de savoir si le brouillon respecte la politique, reflète les faits du dossier et ne nécessite que de légères retouches de la part de l’agent.
- Dépannage guidé : Certains problèmes nécessitent une séquence plutôt qu’une réponse unique. Les meilleurs outils présentent des vérifications ordonnées, des points de décision et une logique d’arborescence afin qu’un agent puisse dérouler un diagnostic sans tâtonner.
- Aide au transfert : Lorsqu’un dossier passe à l’ingénierie, à la facturation ou au produit, la plateforme doit aider à présenter le problème clairement. Une bonne aide au transfert inclut un résumé concis, les étapes déjà réalisées, l’impact client et les bonnes références internes déjà jointes.
- Aide après résolution : Les systèmes performants aident aussi après la réponse. Ils peuvent suggérer des macros, des notes de clôture, une formulation de suivi ou des mises à jour de la base de connaissances liées au dossier qui vient d’être clos.
Ces détails comptent parce que les équipes support ne mesurent pas la réussite uniquement à la recherche. Elles la mesurent à la quantité de travail qu’un agent peut terminer avec moins de reprises, moins d’assemblage manuel de notes et moins d’escalades évitables.
Testez à la fois la consultation rapide et le raisonnement structuré
Tous les dossiers n’ont pas besoin du même type d’assistance. Certains exigent une réponse rapide avec presque aucune interprétation. D’autres nécessitent que le système rassemble plusieurs faits avant que l’agent puisse répondre en toute sécurité.
Testez les deux modes pendant l’évaluation :
- Cas à réponse unique : Exemples : une date limite de résiliation d’abonnement, l’emplacement d’un contrôle d’administration, un statut d’incident en cours, ou la fenêtre de retour correcte pour une commande standard. Dans ces cas, la plateforme doit répondre avec rapidité et précision.
- Cas composites : Exemples : une migration de compte échouée après un changement de forfait, une exception de remboursement liée à des conditions contractuelles, ou un défaut produit qui se superpose à un contournement interne temporaire. Ces cas exigent que la plateforme assemble un chemin exploitable à partir de plusieurs entrées, au lieu de faire remonter un seul article isolé.
La comparaison doit se concentrer sur la friction opérationnelle : combien d’étapes l’agent doit effectuer après l’apparition de la réponse, combien de nettoyage manuel le brouillon nécessite, combien de temps le système met à répondre et à quelle fréquence l’agent doit quitter la vue du dossier pour terminer le travail. Les produits qui gèrent à la fois la recherche directe et le raisonnement structuré ont tendance à mieux tenir quand le volume de support augmente et que le mix de dossiers devient moins prévisible.
Évaluez s’il peut prendre en charge différents niveaux de compétence des agents
La bonne plateforme doit aider un agent moins expérimenté à rester serein face à un dossier inhabituel, sans ralentir un spécialiste qui connaît déjà le terrain. Cela signifie que le système ne doit pas seulement faire remonter une recommandation ; il doit afficher suffisamment de logique, de structure et de signaux de confiance pour permettre à l’agent de décider de la suite.
Pendant les pilotes, demandez aux responsables d’équipe de comparer les résultats selon les niveaux de compétence. Un nouvel agent peut avoir besoin d’un chemin plus clair, d’une explication plus solide et d’un brouillon plus sûr. Un agent senior peut se soucier davantage de la vitesse, de la couverture des cas limites et de la capacité du système à préparer en quelques secondes un dossier d’escalade propre. Un produit solide peut servir les deux sans imposer à un groupe le workflow de l’autre.
C’est aussi là que la conception globale du support devient visible. Certains outils traitent la découverte de connaissances comme une fonctionnalité secondaire à côté du ticketing et du chat. Des plateformes plus mûres la traitent comme une partie du moteur de support lui-même — étroitement liée au triage, à la préparation des réponses, à l’escalade et à la clôture des dossiers. Cette différence tend à façonner la performance au quotidien bien plus qu’une longue liste de fonctionnalités d’IA autonomes.
5. Passez en revue la gouvernance, la sécurité et les contrôles de qualité du contenu
Une fois qu’une plateforme passe en support en production, le standard change. La question n’est plus de savoir si elle peut produire une réponse ; la question est de savoir si votre équipe peut contrôler comment cette réponse est produite, quelles données peuvent l’influencer et ce qui se passe lorsque les preuves sont faibles.
Dans le support en entreprise, la gouvernance est opérationnelle. Les équipes ont besoin de règles claires pour l’accès, l’utilisation des modèles, l’approbation des sources, l’auditabilité et la qualité des connaissances à travers les régions, les unités métier et les niveaux de support. Une plateforme qui répond bien en démo mais échoue sous de vraies contraintes de politique créera plus de travail de relecture qu’elle n’en supprimera.
Le contrôle d’accès doit correspondre à la source, pas à une copie simplifiée
Les environnements support mélangent des données avec des niveaux de risque très différents — règles de remboursement, dossiers de compte, fils de bugs internes, exceptions juridiques et contenu d’aide compatible client sont souvent côte à côte. Une plateforme robuste doit préserver ces frontières sans nécessiter un second cycle de cartographie manuelle des accès dans une nouvelle console d’administration.
Quand vous comparez les plateformes, concentrez-vous sur des comportements de contrôle qui tiennent après le déploiement :
- Alignement des identités : Le système doit s’intégrer à votre couche d’identité — SSO, appartenance aux groupes, changements de rôle et événements de départ doivent façonner l’accès automatiquement.
- Politiques d’IA périmétrées par source : Les équipes doivent pouvoir décider quels référentiels peuvent alimenter l’assistance aux agents, lesquels peuvent alimenter le support en self-service, et lesquels doivent rester consultables mais ne jamais apparaître dans des réponses générées.
- Mises à jour rapides des autorisations : Les changements d’accès doivent se répercuter rapidement après des mouvements d’équipe, des événements de révocation ou l’expiration d’un prestataire ; de longues fenêtres de latence créent une exposition évitable.
- Comportement d’échec sûr : Lorsque la plateforme ne peut pas confirmer l’accès ou le statut d’une source, elle doit retenir le contenu plutôt que deviner.
C’est là que les systèmes faibles montrent leurs limites. Ils paraissent souvent propres au niveau de l’interface, puis se cassent quand les responsables support demandent des contrôles différents entre notes internes, historique de dossier, enregistrements réglementés et contenu d’aide public.
L’ancrage et la fraîcheur façonnent la qualité des réponses
La plupart des erreurs de support ne viennent pas d’un manque total de documentation. Elles viennent d’exceptions anciennes, de politiques dupliquées, de consignes en brouillon jamais retirées, ou d’une réponse de chat qui prend le dessus sur l’article approuvé. Cela rend la discipline des sources aussi importante que la qualité de la récupération.
Demandez aux éditeurs comment la plateforme tranche entre des preuves concurrentes. En support, la bonne réponse peut exister à plusieurs endroits à la fois — une page de politique, un dossier résolu, une note de version et un commentaire d’ingénieur — mais ces sources ne doivent pas avoir le même poids.
- Hiérarchie des sources : Les admins doivent pouvoir classer la documentation approuvée au-dessus des brouillons, des messages de chat ou des tick