- ` is closed prematurely after "Champ de destination", leaving `
- ` items orphaned, with a `
` appearing inside the list structure. This is a serious HTML corruption. 2. **Malformed ` ;` entities**: Throughout sections 5 and 6, the text has ` ;` (with a space before the semicolon) which is invalid HTML. These should be either proper ` ` or just removed. Also French spacing with space before `:` and `;` is rendered oddly. 3. **Broken demo link**: The href was changed to `https://www.glean.com/fr/get-a-demo` but the original is `https://www.glean.com/get-a-demo`. Hrefs must be preserved exactly. Let me provide the corrected HTML:
Comment unifier les métadonnées de plusieurs sources pour améliorer la recherche
Chaque entreprise accumule du contenu dans des dizaines d’outils — systèmes de ticketing, plateformes de collaboration, bases de connaissances, dépôts de code, stockages de fichiers, et plus encore. Chacun étiquette, structure et sécurise ses données différemment. Quand quelqu’un cherche une réponse, la qualité de ce qu’il trouve dépend moins de la barre de recherche elle-même que du fait que les métadonnées sous-jacentes racontent une histoire cohérente à travers toutes ces sources.
L’unification des métadonnées consiste à rassembler ces étiquettes, champs, autorisations et relations dispersés dans un modèle unique et cohérent qu’un système de recherche peut réellement exploiter. Elle transforme des descripteurs fragmentés — où une application appelle un champ « creator », une autre « owner », et une troisième ne stocke qu’un nom en texte libre — en un langage commun qui prend en charge le classement, le filtrage et une récupération précise.
Cet article présente les étapes concrètes qui rendent l’unification des métadonnées efficace dans de vrais environnements d’entreprise. L’accent est mis sur les résultats qui comptent pour les équipes d’ingénierie, de support, commerciales, RH et IT : une découverte plus rapide, des contrôles d’accès fiables, une meilleure pertinence, et une expérience de recherche qui couvre tous les outils sans obliger les utilisateurs à savoir quel système détient la réponse.
Qu’est-ce que l’unification des métadonnées pour la recherche ?
L’unification des métadonnées pour la recherche est le processus d’harmonisation des libellés, champs, autorisations et relations de plusieurs systèmes au sein d’un modèle de recherche unique et cohérent. Plutôt que de laisser chaque application définir son propre vocabulaire — « modified_date » dans un outil, « updated_at » dans un autre, « last_edited » dans un troisième — l’unification fait correspondre ces variations à un schéma commun. Résultat : le contenu devient plus facile à trouver, les contrôles d’accès restent intacts, et le classement, le filtrage ainsi que la qualité des réponses s’améliorent sur l’ensemble de l’écosystème d’outils de l’entreprise.
La distinction est importante, car la qualité de la recherche se dégrade rapidement lorsque chaque source décrit un contenu similaire de manière incompatible. Un ticket de support étiqueté « urgent » dans un système et « P1 » dans un autre peut décrire la même sévérité, mais une couche de recherche sans normalisation les traite comme non liés. Multipliez cette incohérence sur des centaines de champs et des dizaines d’applications, et l’expérience de recherche devient peu fiable — résultats en double, documents manqués, filtres cassés, et réponses auxquelles il manque le contexte dont les utilisateurs ont besoin pour leur faire confiance.
L’objectif : un contexte exploitable, pas seulement l’intégration des métadonnées
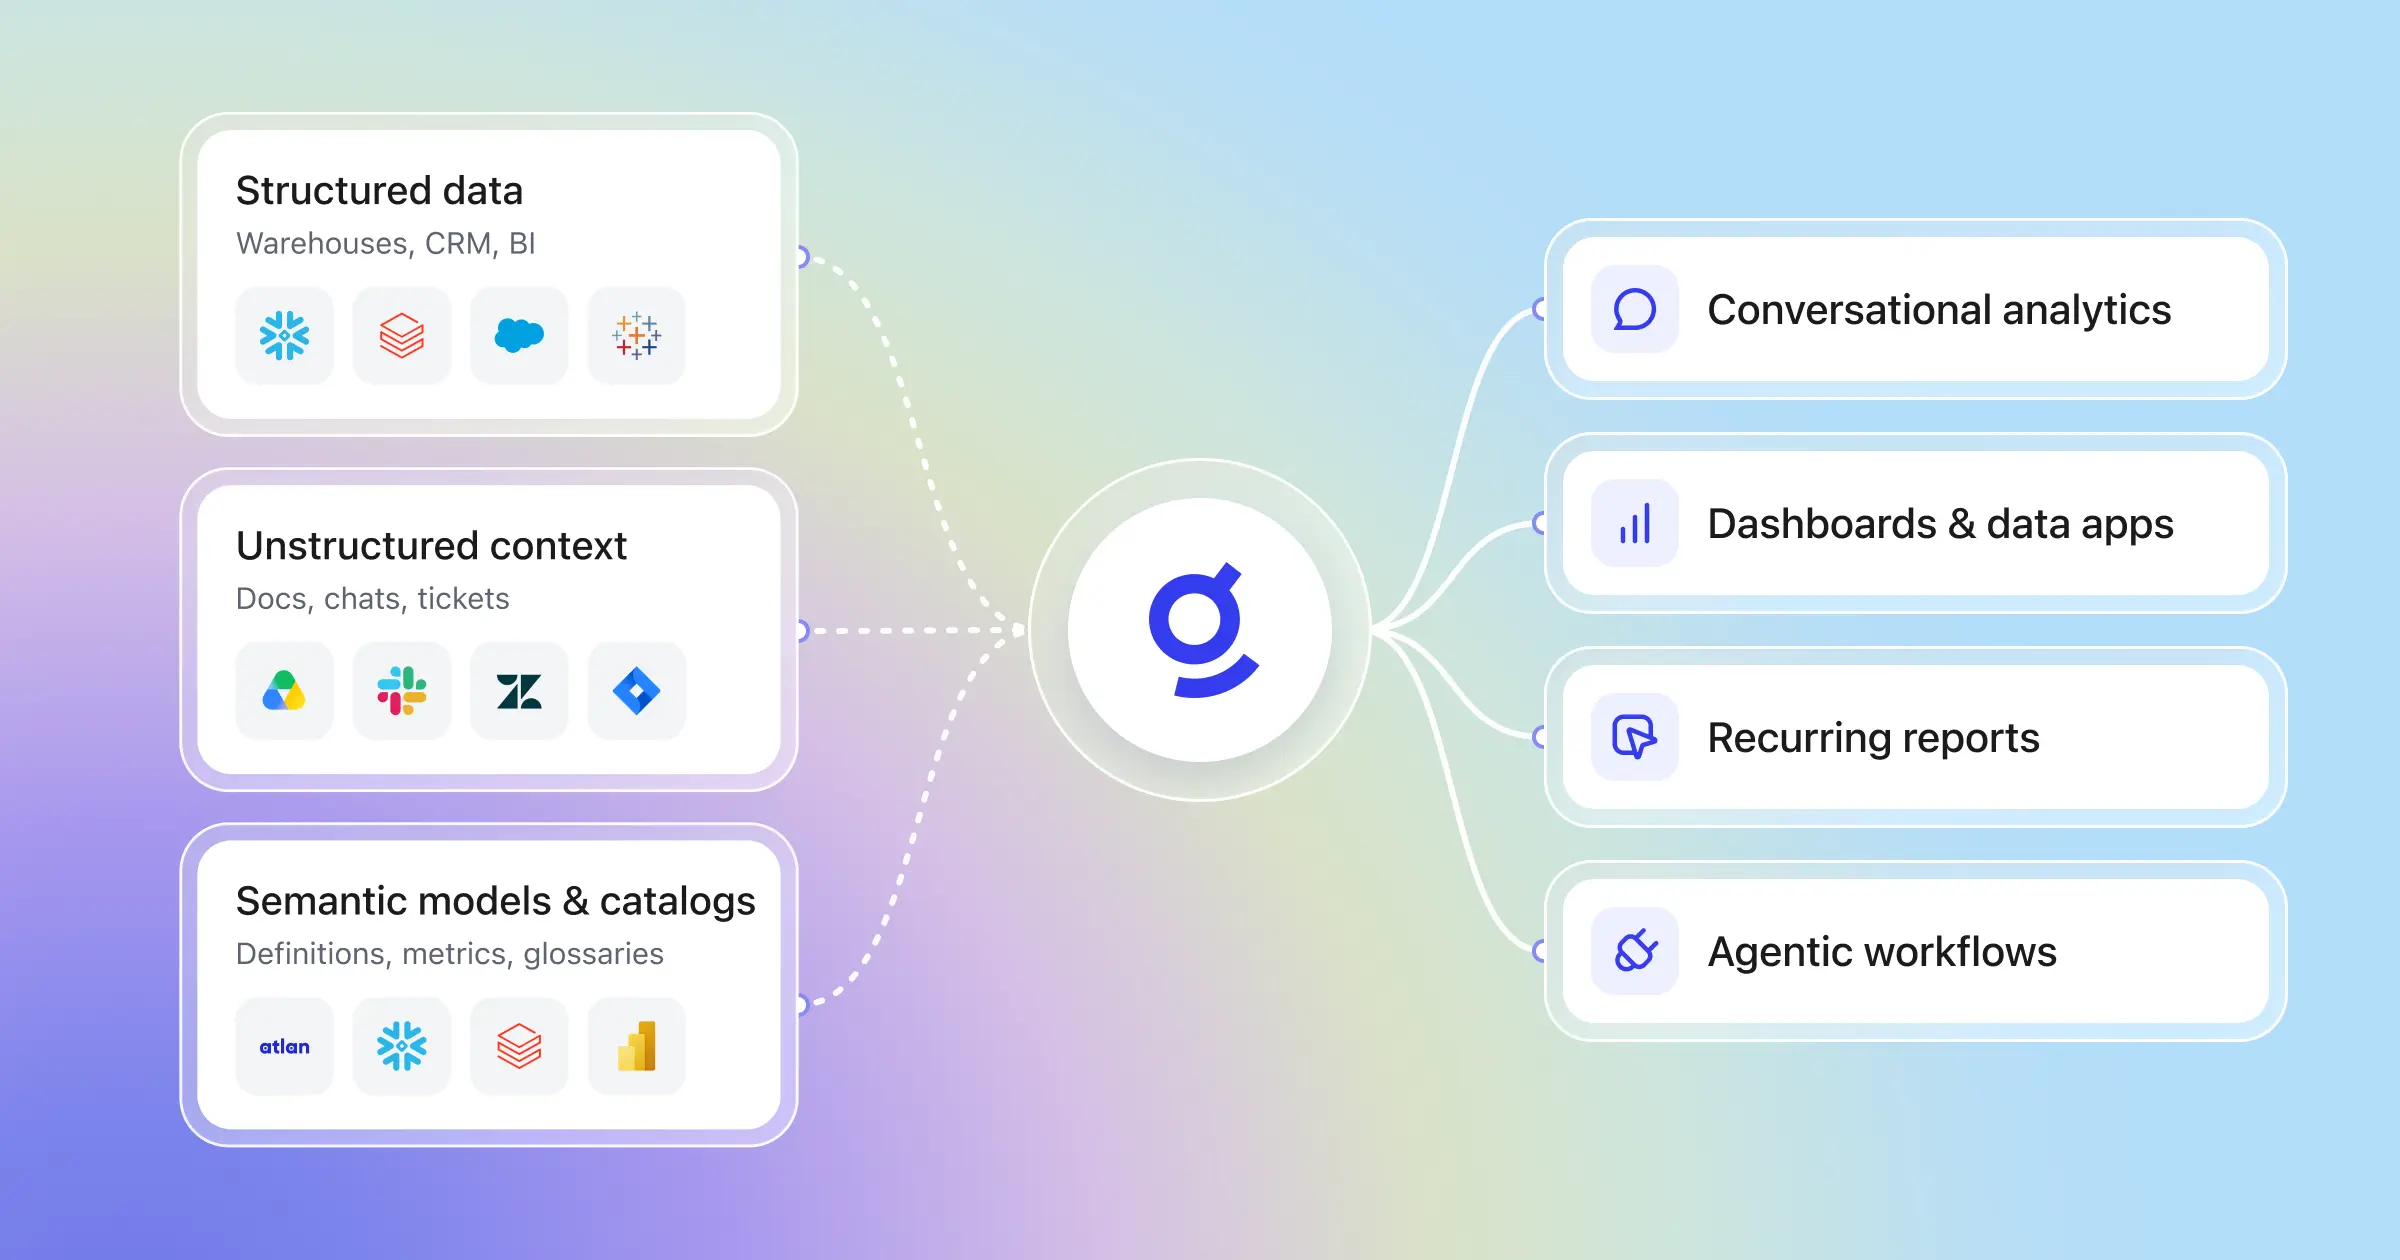
L’unification ne consiste pas à déplacer des champs du point A au point B. Le véritable objectif est un contexte exploitable au moment de la requête — des signaux structurés qui indiquent au système de recherche qui possède un fichier, à quelle équipe il appartient, quand il a été modifié pour la dernière fois, à quel point il est sensible, et qui a l’autorisation de le voir. Cette profondeur de contexte est ce qui distingue un simple index de mots-clés d’une solution de recherche unifiée qui aide réellement les équipes à travailler. Pour les équipes d’entreprise en ingénierie, service client, ventes, IT et RH, des stratégies solides de gestion des métadonnées constituent la base qui rend les méthodes de découverte de données fiables dans les workflows du quotidien.
Plusieurs facteurs rendent cela particulièrement critique dans les environnements d’entreprise modernes :
- Fragmentation du contenu entre les applications : L’information vit dans des wikis, des plateformes de messagerie, des outils de suivi de projet, des CRM, des outils de design et des bases de données internes. Sans couche de métadonnées unifiée, chaque source est un silo — consultable seule, invisible pour tout le reste.
- Recherche sémantique et récupération assistée par l’IA : Les systèmes de recherche intelligents et les moteurs de réponse propulsés par des LLM donnent le meilleur d’eux-mêmes lorsqu’ils peuvent utiliser des signaux de contexte et d’intention au-delà des mots-clés bruts. Des métadonnées cohérentes — types d’objets normalisés, horodatages fiables, identités résolues — permettent à un système d’interpréter une requête comme « dernière politique de sécurité approuvée » plutôt que de simplement faire correspondre le mot « politique ».
- Complexité des autorisations à grande échelle : La recherche d’entreprise doit respecter les contrôles d’accès de chaque source connectée. Une unification des métadonnées qui préserve et actualise les autorisations garantit que les utilisateurs ne voient que ce à quoi ils sont autorisés, ce qui est non négociable pour la confiance et la conformité.
Cet article se concentre sur des étapes pratiques qui améliorent la compatibilité des sources de données, les techniques d’optimisation de la recherche et la qualité de la récupération d’informations — sans forcer chaque système à entrer dans un moule unique et rigide. Les sections suivantes couvrent l’audit des sources, la conception d’un schéma canonique, la normalisation des champs, la préservation des autorisations, l’enrichissement, l’indexation et la gouvernance continue. Chaque étape contribue à bâtir une base de recherche où les métadonnées fonctionnent comme une couche cohérente plutôt que comme un patchwork de descripteurs déconnectés.
Comment unifier les métadonnées de plusieurs sources pour améliorer la recherche
Définissez la cible avant de commencer le travail sur les connecteurs : un rappel cohérent entre les systèmes, un classement prévisible, des filtres exploitables, des autorisations à jour, et des fenêtres de fraîcheur qui correspondent au rythme de chaque source. Cette cible donne à l’équipe un standard concret pour chaque choix de conception qui suit — quels champs comptent, quelles sources nécessitent une synchronisation quasi en temps réel, quels enregistrements doivent être dédupliqués, et quels manques de métadonnées feront échouer la récupération.
Traitez les métadonnées comme une infrastructure de recherche, pas comme de la plomberie d’import. Les titres façonnent les libellés des résultats ; les types d’objets façonnent le classement et les mises en page des résultats ; les propriétaires et les équipes façonnent l’autorité ; les horodatages façonnent la fraîcheur ; les autorisations façonnent la confiance. Lorsque ces signaux varient selon la source, la couche de recherche n’a aucune base stable pour la récupération, l’ancrage ou la navigation par facettes. Le travail ci-dessous compte le plus dans les entreprises où pages de wiki, dossiers de support, fichiers PDF, tableaux de bord, enregistrements CRM, profils d’employés et objets de workflow internes coexistent dans une même surface de recherche.
Commencez par l’objectif de recherche, pas par le schéma source
Le premier choix de conception n’est pas la cartographie de schéma. C’est l’analyse du comportement de recherche — ce que les gens essaient de trouver, quels filtres ils attendent, à quelle fréquence ils affinent leurs requêtes, et à quel moment ils perdent confiance. Les logs de requêtes, tickets de support, analyses des recherches sans résultat, et entretiens avec les équipes d’ingénierie, support, RH, ventes et IT révèlent généralement le même schéma : les utilisateurs recherchent par concepts métiers comme le statut d’une politique, le périmètre produit, le compte, la région, le projet, la sévérité ou l’équipe, tandis que les systèmes sources exposent un mélange de noms de champs techniques qui ne s’alignent pas proprement.
C’est dans cet écart que l’unification des métadonnées apporte sa valeur. Un modèle utile reflète la manière dont les gens cherchent, puis mappe les champs sources vers ce modèle selon des règles claires. Une plateforme de service client peut exposer la file, le responsable, la sévérité et l’état du dossier ; un dépôt de documents peut exposer le type de document, le propriétaire et l’état d’approbation ; une plateforme BI peut exposer le domaine du tableau de bord, le steward et la cadence de mise à jour. La recherche fonctionne mieux lorsque ces attributs atterrissent dans une structure partagée qui prend en charge des schémas de récupération courants plutôt que de reproduire chaque source exactement telle qu’elle est arrivée.
Construire la base en trois parties
L’implémentation tient généralement mieux dans le temps lorsque trois couches techniques restent séparées, mais coordonnées :
- Connexion et ingestion : Extraire le contenu, les métadonnées, les identités et les contrôles d’accès depuis chaque source, selon le mode de mise à jour que chaque source prend en charge. Les flux d’événements fonctionnent bien pour les systèmes à forte fréquence de changement ; la synchronisation planifiée convient aux référentiels plus lents ; des API sur mesure comblent souvent les lacunes des outils internes. L’objectif n’est pas seulement la couverture — c’est une fraîcheur prévisible.
- Normalisation et modélisation : Mapper les champs des sources vers un schéma canonique, standardiser les types de données, appliquer des vocabulaires contrôlés lorsque les filtres dépendent de la cohérence, et conserver la provenance pour la traçabilité. Une date doit toujours s’analyser comme une date ; une personne doit correspondre à une seule identité ; un champ de cycle de vie ne doit pas signifier brouillon dans un outil et publié dans un autre.
- Recherche et récupération : Indexer ensemble le texte intégral et les champs structurés, puis utiliser les métadonnées comme une couche active de classement et de contraintes. Les métadonnées structurées doivent alimenter les facettes, la mise en forme en fonction de la source, le regroupement des résultats, la détection des doublons et les règles de récupération pour les systèmes de réponses qui ont besoin d’un contexte étayé.
Cette séparation aide les équipes à faire évoluer une couche sans déstabiliser les autres. Un connecteur peut obtenir des données d’accès plus riches ; une taxonomie peut passer de « HR » à « Human Resources » ; une règle de classement peut favoriser le contenu approuvé plutôt que les brouillons — le tout sans imposer une refonte de l’ensemble de la pile.
Suivre le travail en sept parties
- Auditer le paysage des sources : Établir un inventaire de tous les systèmes qui doivent être inclus dans la recherche, puis documenter les champs que chacun expose, les identifiants qu’il utilise, le modèle d’accès qu’il suit et la manière dont les mises à jour arrivent. Capturer aussi ce qui manque — horodatages obsolètes, propriétaires en texte libre, libellés de type faibles, ou absence d’IDs d’objet stables.
- Définir le schéma canonique : Créer le modèle partagé sur lequel le système de recherche s’appuiera. Commencer par des champs pérennes comme le titre, la description, le corps, la source, le type d’objet, l’URL, la date de création, la date de mise à jour, le propriétaire, l’équipe, la langue, le statut du cycle de vie et les permissions ; n’ajouter des extensions spécifiques à une source que là où elles améliorent la trouvabilité.
-
Créer des correspondances de champs : Mapper chaque champ source vers le modèle canonique avec des règles de transformation explicites. C’est ici que
headline,titleetdocument_namepeuvent converger vers un seul champ, tandis quecreator,writeretownerpeuvent se mapper différemment selon qu’ils indiquent l’auteur, le responsable ou la responsabilité d’accès. - Normaliser les valeurs et résoudre les entités : Standardiser les libellés qui pilotent le classement ou le filtrage — départements, régions, statuts, types de contenu, noms de produits, identifiants de projet. Résoudre les doublons de personnes, d’équipes et d’objets métier à travers les noms d’utilisateur, les emails et les variantes de dénomination afin que les signaux d’autorité et de collaboration ne se fragmentent pas.
- Préserver la provenance et les permissions : Conserver, attachés à chaque élément indexé, le système source, les noms de champs d’origine, les horodatages de synchronisation, les IDs d’objet et les métadonnées d’accès. Ce contexte facilite le débogage, l’audit et une récupération sécurisée ; il évite aussi que la couche de recherche n’occulte quel système reste la source de vérité.
- Enrichir ce qui améliore la trouvabilité : Ajouter uniquement les métadonnées qui aident les utilisateurs à affiner, faire confiance et comprendre les résultats. Les points d’enrichissement courants incluent la classification par sujet, le niveau de sensibilité, la détection de langue, le projet ou client lié, l’alignement sur un glossaire et les relations entre enregistrements, par exemple une spécification liée à un ticket ou une politique liée à l’équipe propriétaire.
- Indexer, mesurer et ajuster : Structurer l’index pour que le texte intégral assure le rappel tandis que les métadonnées assurent la précision. Suivre les taux de valeurs nulles sur les champs critiques, les échecs de synchronisation des permissions, les enregistrements obsolètes, les clusters de doublons, l’usage des filtres, la reformulation des requêtes et le temps jusqu’au premier résultat utile ; ces signaux montrent où le modèle doit être affiné.
Cette séquence compte, car la qualité de recherche dépend d’effets cumulatifs. Un inventaire des sources faible laisse des angles morts ; des correspondances faibles entraînent une dérive sémantique ; une normalisation faible casse les facettes ; une provenance faible ne laisse aucun chemin pour corriger les erreurs ; une mesure faible laisse l’équipe deviner. Une unification solide des métadonnées donne à la couche de recherche un modèle d’exploitation fiable pour la récupération, le classement et la génération de réponses étayées à travers des contenus d’entreprise complexes.
1. Auditez vos sources et les métadonnées qu’elles exposent déjà
Cartographiez la surface de recherche avant de commencer tout travail de schéma. Le bon inventaire ne commence pas par les seules applications ; il commence par le travail que les personnes s’attendent à couvrir avec une seule requête, à travers l’ingénierie, le support, les ventes, les RH et l’IT.
Cela inclut généralement les systèmes documentaires, l’historique de chat, les outils de suivi d’incidents, les tableaux de bord, les plateformes d’hébergement de code, les lecteurs partagés, les enregistrements clients, les données de personnes et des outils internes sur mesure. Pour chaque source, capturez le propriétaire du système, la méthode d’extraction, les classes d’objets, le format des identifiants et toute limite connue en matière d’accès ou d’export ; c’est là que les angles morts apparaissent tôt.
Cataloguez ce que chaque source peut réellement fournir
Créez un profil de source pour chaque système, avec les champs qu’il expose aujourd’hui, le type de champ, des exemples de valeurs et la fréquence d’apparition de chaque champ. Allez au-delà des libellés évidents et vérifiez aussi la fiabilité des champs ; un horodatage qui existe sur chaque enregistrement mais signifie trois choses différentes n’est pas une entrée utile pour la recherche.
Un profil de source pratique devrait inclure :
- Descripteurs principaux : titre, headline, sujet, résumé, nom de fichier, nom de page, ou tout champ qu’un utilisateur reconnaîtrait dans une liste de résultats.
- Auteur et propriété : creator, éditeur, assigné, manager, approbateur, propriétaire de file, ou compte de service ; notez si la valeur pointe vers une personne réelle ou une identité système.
- Signaux temporels : créé, publié, clôturé, résolu, dernier consulté, dernier indexé, ainsi que toute date de rétention ou d’expiration qui affecte la fraîcheur.
- Libellés d’objet : type d’enregistrement, classe de contenu, type de cas, dépôt, espace de travail, espace d’équipe, chemin de dossier, ou domaine métier.
- Attributs d’accès : droits directs utilisateur, droits de groupe, accès hérité, indicateurs de partage externe, et limites de tenant ou de domaine.
- Champs natifs de la source : priorité de cas, branche de dépôt, état de revue, entité juridique, marché, région, ou tout attribut sur lequel les utilisateurs s’appuient pour affiner les résultats.
Les noms de champs seuls ne racontent pas toute l’histoire. Une plateforme peut stocker un « owner » comme une liste de diffusion, une autre comme un numéro d’employé, et une troisième en texte libre ; cette différence affecte la résolution d’identité, le classement et la qualité des filtres plus tard.
Mesurer les parcours de mise à jour et les contraintes de synchronisation
La qualité de la recherche dépend de la manière dont les métadonnées entrent dans le système, pas seulement des champs disponibles. Indiquez si chaque source prend en charge les webhooks, les flux d’événements, les exports planifiés, les lectures API incrémentales, les explorations complètes, ou uniquement l’extraction manuelle ; ces mécanismes déterminent la rapidité avec laquelle les nouveaux contenus, les modifications, les déplacements et les suppressions apparaissent dans les résultats.
C’est aussi là que les limites opérationnelles comptent. Certains systèmes publient chaque événement de changement ; d’autres n’exposent que des instantanés périodiques, des signaux de suppression incomplets, ou des quotas d’API stricts. Un catalogue de dashboards peut tolérer une synchronisation horaire, tandis que les canaux d’incident, les notes de dossier et les enregistrements de projet en direct exigent une latence bien plus faible pour rester fiables.
Vérifier les mécanismes d’autorisation au niveau de l’élément
Ne traitez pas la sécurité comme un chantier séparé. Auditez la manière dont chaque source exprime l’accès au niveau de l’objet : autorisations directes, appartenance à des groupes imbriqués, héritage d’espace de travail, héritage de dossier, règles au niveau des lignes, restrictions de domaine et exceptions d’accès invité.
Le format d’identité exige la même rigueur. Une source peut s’appuyer sur des identifiants SSO, une autre sur des alias e-mail, une autre sur des identifiants RH, et une autre sur des noms d’utilisateur locaux ; une couche de recherche unifiée doit réconcilier ces modèles sans affaiblir les contrôles de la source ni afficher des enregistrements en dehors de leur audience prévue.
Signaler les constats d’audit qui bloqueront la qualité de la recherche
Un audit solide fait plus que lister les systèmes et les champs ; il met au jour les défauts qui déformeront la récupération plus tard. Les blocages courants incluent des propriétaires nuls, des identifiants recyclés, des exports dupliqués provenant de dépôts en miroir, des libellés de type non contrôlés, des mappages de groupes cassés, des objets enfants masqués, et des dates qui reflètent le moment d’ingestion plutôt que le véritable changement de contenu.
C’est aussi à ce stade que la couverture des connecteurs devient claire. Certaines sources s’inscrivent dans des schémas d’ingestion standard, tandis que d’autres nécessitent un traitement sur mesure pour des API propriétaires, des bases de données internes ou des systèmes métier ; cette distinction façonne le plan de construction de l’intégration des métadonnées bien avant que le mapping de schéma ne commence.
2. Définir un modèle de métadonnées canonique qui couvre l’ensemble des systèmes
Un inventaire vous indique ce que chaque dépôt expose ; un modèle canonique décide de ce que la couche de recherche peut considérer comme fiable. Il agit comme un contrat de recherche pour chaque système connecté, de sorte que les documents, tickets, dashboards, messages et enregistrements arrivent avec une forme prévisible même lorsque leurs schémas natifs diffèrent.
Gardez ce contrat minimal. La recherche n’a pas besoin de chaque champ source ; elle a besoin des champs qui soutiennent la pertinence, le filtrage, la sécurité et un affichage clair des résultats à l’échelle de l’entreprise.
- Identité de l’enregistrement : un ID source stable, un libellé du système source et une URL canonique afin que chaque élément reste traçable et que la déduplication reste possible.
- Descripteurs de contenu : titre, texte principal ou extrait, type d’objet et langue afin que le système puisse classifier et retrouver correctement l’élément.
- Signaux de propriété : identité du propriétaire et équipe propriétaire afin que la recherche puisse associer le contenu aux bonnes personnes et au bon contexte opérationnel.
- Signaux temporels : date de création et date de mise à jour dans un format unique afin que la fraîcheur fonctionne comme un véritable signal de classement plutôt que comme un indice vague.
- Signaux de contrôle : autorisations et statut du cycle de vie afin que les utilisateurs ne voient que du contenu valide, actuel et autorisé.
Concevoir pour le comportement de recherche, pas pour le comportement des sources
Les requêtes des utilisateurs doivent façonner le modèle. Les gens recherchent des revues d’incident, des politiques approuvées, des escalades client, des notes de version, des plans d’onboarding, des décisions d’architecture et des conditions de renouvellement ; le schéma doit représenter directement ces schémas d’usage au lieu de refléter la disposition de champs qu’un système source utilise par hasard.
Cela signifie que chaque champ important a besoin d’une définition claire et unique. Un horodatage doit suivre un format standard, tel que ISO 8601. Une référence à une personne doit se résoudre en une clé d’identité d’entreprise unique. Un champ de cycle de vie doit utiliser un ensemble de valeurs contrôlé plutôt qu’un mélange de « open », « active », « live » et « current » pour le même état. Lorsque la recherche voit des entités, des types de contenu et des attributs porteurs d’intention cohérents, elle peut dépasser la correspondance littérale des termes et interpréter les demandes avec beaucoup plus de précision.
Étendre avec prudence
Un schéma cœur solide couvre chaque objet indexé, mais certains types de contenu ont besoin de plus de détails. Un dossier peut nécessiter la priorité, la file, l’état du SLA et le code de résolution. Un dashboard ou un dataset peut nécessiter un steward, un statut de certification, une cadence de rafraîchissement et un domaine métier. Un artefact de code peut nécessiter le dépôt, le nom du service, l’environnement et la release train.
Ces champs doivent vivre dans des extensions typées, et non dans la couche universelle. Cela maintient le modèle commun propre tout en donnant aux classes d’objets à forte valeur les métadonnées dont elles ont besoin pour une meilleure trouvabilité. La recherche peut alors utiliser ces extensions uniquement lorsqu’elles comptent, par exemple lorsque quelqu’un filtre les dashboards certifiés ou recherche des dossiers non résolus de priorité 1.
Utiliser des standards légers pour maintenir la stabilité du modèle
Les standards aident surtout comme points de référence, pas comme doctrine. Les champs descriptifs peuvent s’inspirer de Dublin Core, les entités structurées peuvent suivre des patterns de Schema.org, et les actifs de type dataset peuvent prendre des repères auprès de DCAT. Cette approche donne au modèle une forme durable sans transformer la conception du schéma en un projet de gouvernance à part entière.
La stabilité compte parce que chaque décision ultérieure en dépend : mapping de champs, normalisation, filtres, signaux de classement, récupération sémantique et ancrage des réponses. Avec un contrat durable pour l’identité, le type, le temps et l’accès, les systèmes en aval peuvent opérer sur des attributs connus plutôt que sur des hypothèses fragiles spécifiques à chaque source.
3. Mapper, normaliser et résoudre les champs équivalents entre les sources
Avec le schéma partagé en place, l’étape suivante est opérationnelle : transformer les métadonnées spécifiques aux sources en enregistrements prêts pour la recherche avec des règles reproductibles. Ce travail se situe dans la couche de transformation, où les mappages de champs, le nettoyage des valeurs, la gestion des conflits et le rapprochement des identités façonnent ce que l’index de recherche peut considérer comme fiable.
La partie difficile n’est pas le volume d’ingestion. La partie difficile, c’est la cohérence dans des conditions réelles d’entreprise — champs partiels, libellés hérités, objets dupliqués et systèmes sources qui décrivent la même chose de manière incompatible. Une couche de mapping solide gère explicitement ces différences, afin que le classement et la récupération ne dépendent pas d’exceptions.
Mapper les champs source vers le schéma partagé
Commencez par une table de mapping source par source. Pour chaque connecteur, définissez quel champ source alimente quel champ partagé, quelle conversion s’applique, quel système fait autorité lorsque les valeurs sont en conflit, et quelle logique de repli s’applique lorsque la source omet une valeur.
Une spécification de mapping pratique couvre généralement quatre décisions :
-
Champ de destination : Le champ de recherche exact à renseigner, comme
owner,content_type,updated_date, ouregion. - Logique de transformation : La règle qui convertit les valeurs sources au format cible — analyse des dates, nettoyage des chaînes, traduction des énumérations, ou recherche via une table de référence.
- Règle de priorité : La source qui l’emporte lorsque plusieurs systèmes revendiquent le même attribut. Un annuaire peut faire autorité pour le manager et le département ; une plateforme de contenu peut faire autorité pour le titre et l’URL.
- Gestion des valeurs nulles et des conflits : Le comportement lorsqu’une valeur est vide, mal formée, dupliquée ou contradictoire.
C’est aussi là que de nombreuses équipes introduisent des erreurs silencieuses. Un champ nommé
ownerpeut désigner le téléverseur dans un système, l’approbateur métier dans un autre, et l’attributaire actuel dans un troisième. Une table de mapping doit capturer cette distinction directement, au lieu de supposer que la similarité des noms de champs équivaut à une équivalence de sens.Normaliser d’abord les incohérences évidentes
Après le mapping, nettoyez les incohérences à forte fréquence qui déforment le comportement de recherche. Il s’agit généralement de problèmes mécaniques qui affectent les filtres, l’ordre de tri et les signaux de classement bien avant que quiconque ne les remarque dans l’UI.
Une passe de normalisation ciblée inclut souvent :
- Normalisation des dates : Convertir les horodatages vers une norme unique, préserver la logique de fuseau horaire, et distinguer l’heure de création de l’heure de modification et de l’heure d’indexation.
-
Normalisation des types : Regrouper des libellés spécifiques aux sources comme
pptx,presentationetslide deckdans une seule classe de recherche lorsque cette distinction améliore la récupération. -
Normalisation des états : Aligner des libellés de workflow comme
new,active,pending,openetawaiting reviewsur un ensemble stable d’états de recherche. - Nettoyage du texte : Standardiser la casse, la ponctuation, les espaces et les modèles de délimiteurs afin que la navigation par facettes ne sépare pas des valeurs équivalentes dans des compartiments distincts.
- Normalisation des références : Mettre les codes de région, les clés de projet, les libellés de département et les marqueurs de cycle de vie dans un format unique approuvé avant l’indexation.
Ce travail doit rester intentionnel. Les systèmes de recherche ont besoin de moins de valeurs, plus claires — pas d’une infinité de variantes spécifiques aux sources qui paraissent précises mais affaiblissent le classement et encombrent les filtres.
Résoudre les équivalences sémantiques, pas seulement la syntaxe
Une fois les problèmes de format sous contrôle, le défi suivant est l’alignement conceptuel. Différents systèmes utilisent souvent des termes différents pour la même entité métier, et ces différences affectent le rappel plus que la plupart des équipes ne l’imaginent.
La solution n’est pas un simple thésaurus. Elle exige un mapping sémantique délibéré qui relie les libellés natifs des sources à des concepts partagés utilisés par la couche de recherche. En pratique, un enregistrement d’une plateforme finance libellé
client, un ticket support libelléaccountet un enregistrement commercial libellécustomerpeuvent tous renvoyer à la même classe d’entités à des fins de récupération. Le même schéma apparaît avec des termes commeincident,caseetservice event, oupolicy,controletstandard, selon le contexte métier.Une manière utile de gérer cela est de disposer d’un registre de concepts — une liste maintenue de termes métier normalisés, d’alias acceptés et de variantes spécifiques aux systèmes. Ce registre donne à la couche de recherche une cible sémantique stable sans obliger les systèmes sources à renommer leurs objets. Il améliore aussi la compréhension des requêtes, car le système peut interpréter le langage des utilisateurs et le langage des sources comme faisant partie d’un même modèle de récupération.
Utiliser la résolution d’entités pour les personnes, les équipes et les objets métier
Le nettoyage des champs à lui seul ne résout pas la fragmentation des identités. La qualité de la recherche dépend d’entités stables, en particulier lorsque les utilisateurs s’attendent à ce que les résultats reflètent la propriété, l’expertise, les schémas de collaboration ou un contexte métier partagé.
La résolution d’entités doit faire correspondre des enregistrements qui renvoient au même objet sous-jacent même lorsque les identifiants diffèrent. Les entrées courantes incluent des IDs d’annuaire, des alias d’e-mail, des noms d’utilisateur, des dossiers RH, des IDs de comptes CRM, des codes projet et des noms de lieux. Les règles de matching combinent souvent des identifiants exacts avec des tables d’alias, des données de référence et un scoring de confiance. Les correspondances à haute confiance peuvent fusionner automatiquement ; celles à plus faible confiance peuvent nécessiter une logique de revue ou des files d’exceptions.
Trois classes d’entités méritent généralement une attention précoce :
- Personnes : Relier les dossiers employés, les données de profil, les alias et les noms d’utilisateur des applications en une identité unique consultable.
- Équipes : Aligner les noms d’organisation, les groupes fonctionnels, les libellés d’espaces de travail et les noms de groupes dérivés des centres de coûts lorsqu’ils représentent la même unité.
- Objets métier : Réconcilier les produits, clients, projets, bureaux et domaines qui apparaissent dans plusieurs systèmes avec des conventions de nommage incohérentes.
Sans cette étape, les signaux relationnels restent fragmentés. La propriété paraît plus faible qu’elle ne l’est, les signaux d’expertise se disloquent et le contenu connexe n’arrive pas à se regrouper autour des personnes et des entités métier qui lui donnent son contexte.
Conserver les valeurs normalisées et brutes côte à côte
Une couche de recherche a besoin de métadonnées propres, mais les équipes opérationnelles ont toujours besoin de transparence sur la source. Le modèle le plus sûr est un stockage dual : un champ pour la valeur normalisée utilisée dans le classement et le filtrage, et un champ pour la valeur native de la source utilisée pour l’inspection, la traçabilité et le support.
Cette approche répond à plusieurs besoins opérationnels à la fois :
- Analyse des problèmes : Les équipes peuvent inspecter pourquoi un enregistrement s’est retrouvé dans une facette, pourquoi un ordre de tri a changé, ou pourquoi deux éléments n’ont pas réussi à se regrouper.
- Revue et audit : Les responsables des données peuvent comparer les valeurs transformées aux valeurs natives de la source sans rétroconcevoir le pipeline.
- Gestion du changement : Lorsqu’une application source modifie la définition d’un champ ou introduit une nouvelle énumération, la valeur brute rend la dérive visible tôt.
- Confiance dans le contexte de la source : Les résultats de recherche peuvent rester cohérents tout en préservant le libellé original de l’objet, l’identifiant source et l’URL source.
Cet équilibre compte, car la recherche exige de la standardisation, tandis que la gouvernance d’entreprise exige de la traçabilité. Un pipeline de métadonnées mature fait les deux en même temps.
4. Préserver les autorisations, l’identité et le contexte de la source de vérité
Une fois le schéma partagé en place, le risque suivant se situe dans la dérive. Les droits d’accès changent, les propriétaires changent, les enregistrements se déplacent entre dossiers ou projets, et les liens expirent ; la couche de recherche doit refléter ces changements avec la même précision que le système source.
Cette partie de l’architecture détermine si les utilisateurs font confiance à la page de résultats. Une expérience de recherche sécurisée repose sur des droits d’accès à jour, des références d’identité stables et une provenance claire pour chaque élément qui entre dans l’index.
Maintenez les contrôles d’accès attachés à l’élément
La gestion des autorisations a besoin d’un modèle opérationnel, pas seulement d’un champ dans le schéma. Certains systèmes publient des événements de modification lorsqu’un partage de document change ; d’autres exigent des vérifications planifiées des ACL, des annuaires de groupes ou des politiques d’espace de travail. Le pipeline de recherche doit prendre en charge ces deux modèles afin que les systèmes à forte fréquence de changements restent à jour sans imposer la même cadence d’actualisation à des référentiels plus lents.
Une conception solide inclut généralement trois contrôles :
- Synchronisation des autorisations basée sur les deltas : retraiter uniquement les éléments dont l’état d’accès a changé — mises à jour de groupes, déplacements de dossiers, liens révoqués, modifications d’appartenance à un projet ou changements de politique. Cela maintient l’index à jour sans réingestion complète.
- Évaluation des accès au moment de la requête : utiliser les données de droits indexées pour filtrer les résultats avant l’affichage ou la génération de réponses. Cela maintient une récupération sécurisée rapide et évite un post-traitement large a posteriori.
- Visibilité des défaillances : suivre les ACL obsolètes, l’expansion de groupes défaillante et le retard de synchronisation comme des problèmes de qualité de premier ordre. Un pipeline d’autorisations sans supervision se transforme en dette de recherche silencieuse.
Cette approche aide aussi avec les objets composites. Un tableau de bord peut hériter des accès d’un espace de travail, tandis qu’un fichier joint peut porter son propre ensemble de règles ; l’index doit préserver cette distinction afin que le système puisse évaluer chaque élément selon ses propres conditions.
Traitez l’identité comme une métadonnée de premier ordre
L’identité a besoin de sa propre couche de résolution, car les systèmes d’entreprise s’accordent rarement sur la manière de représenter les personnes et les équipes. Une plateforme RH peut stocker un identifiant employé, un système de contenu peut utiliser l’e-mail, une plateforme de code peut utiliser un pseudonyme, et un outil de support peut s’appuyer sur l’appartenance à une file. La qualité de recherche s’améliore lorsque ces références se résolvent vers un enregistrement d’entité unique et durable, capable de survivre aux changements de rôle, aux alias et aux mouvements d’organisation.
Cette couche d’identité doit capturer les relations qui aident le système à interpréter le contexte de travail avec précision. En pratique, cela signifie souvent un graphe de personnes, équipes, dépôts, projets et unités métier — pas seulement un champ propriétaire plat. Un moteur de recherche peut alors distinguer un document détenu par une équipe, un brouillon modifié par un contributeur individuel et une politique approuvée via une chaîne formelle. Ce contexte compte encore davantage pour les systèmes de réponse, qui doivent ancrer les réponses dans des enregistrements dotés de la bonne légitimité organisationnelle plutôt que dans le texte qui se classe simplement en premier.
Rendez l’origine visible
Une expérience unifiée fonctionne mieux lorsque la provenance reste explicite. Chaque enregistrement indexé doit porter suffisamment de contexte de source pour permettre l’inspection, le triage et les décisions de classement — clé de l’objet source, conteneur natif, horodatage de synchronisation, libellé du référentiel, et la référence qui permet à l’utilisateur d’ouvrir l’enregistrement d’origine in situ.
Cette provenance aide aussi à gérer les conflits. Deux systèmes peuvent contenir des copies quasi dupliquées d’un même document, mais l’un peut rester l’enregistrement faisant autorité parce qu’il a le workflow actif, l’approbateur actuel ou l’état de conservation le plus récent. La couche de recherche ne doit pas deviner face à cette ambiguïté. Elle doit utiliser des règles de provenance, une priorité des sources et des métadonnées de cycle de vie pour classer la bonne version plus haut, tout en préservant la relation entre les copies.
Là où les conteneurs parents définissent un contexte métier significatif, l’index doit porter ce contexte en avant de manière contrôlée. Un projet peut conférer une propriété de domaine, un espace de travail peut conférer une portée de politique, et un dépôt peut conférer un contexte d’équipe ; ces signaux aident le système à interpréter les résultats sans effacer la structure de la source elle-même.
5. Enrichir les métadonnées avec la classification, les relations et le contexte métier
À ce stade, la couche de recherche peut identifier un élément et appliquer les bonnes règles d’accès. L’enrichissement ajoute les signaux qui l’aident à déterminer quel élément mérite la priorité lorsque plusieurs résultats se ressemblent en surface.
Cette étape est importante, car le contenu d’entreprise porte rarement suffisamment de sens dans les seuls champs bruts de la source. Un tableau de bord, un ticket, une note de feuille de route et un mémo de politique peuvent tous mentionner le même nom de client ou nom de code de projet ; ce sont les métadonnées enrichies qui indiquent au système si ce terme renvoie à la propriété, à l’impact, à la géographie ou au sujet.
Ajoutez le contexte que les gens utilisent
Les meilleurs
updated_date, ou region.` outside, and subsequent `