Intégrer les modèles OpenAI à l’IA d’entreprise : comparaison
L’intégration de l’IA d’entreprise connecte des modèles de raisonnement avancés à une plateforme qui applique les autorisations, récupère les données internes et gouverne les sorties — transformant des modèles de langage généralistes en outils qui répondent à des questions en s’appuyant sur les connaissances réelles de l’entreprise.
Cette distinction est importante, car un grand modèle de langage (LLM) autonome n’a aucune visibilité sur les documents, tickets, politiques ou la structure hiérarchique de votre organisation. Il génère un texte plausible issu de données d’entraînement publiques, mais il ne peut pas consulter les chiffres de revenus du trimestre précédent, citer la bonne politique RH, ni respecter qui doit voir quoi.
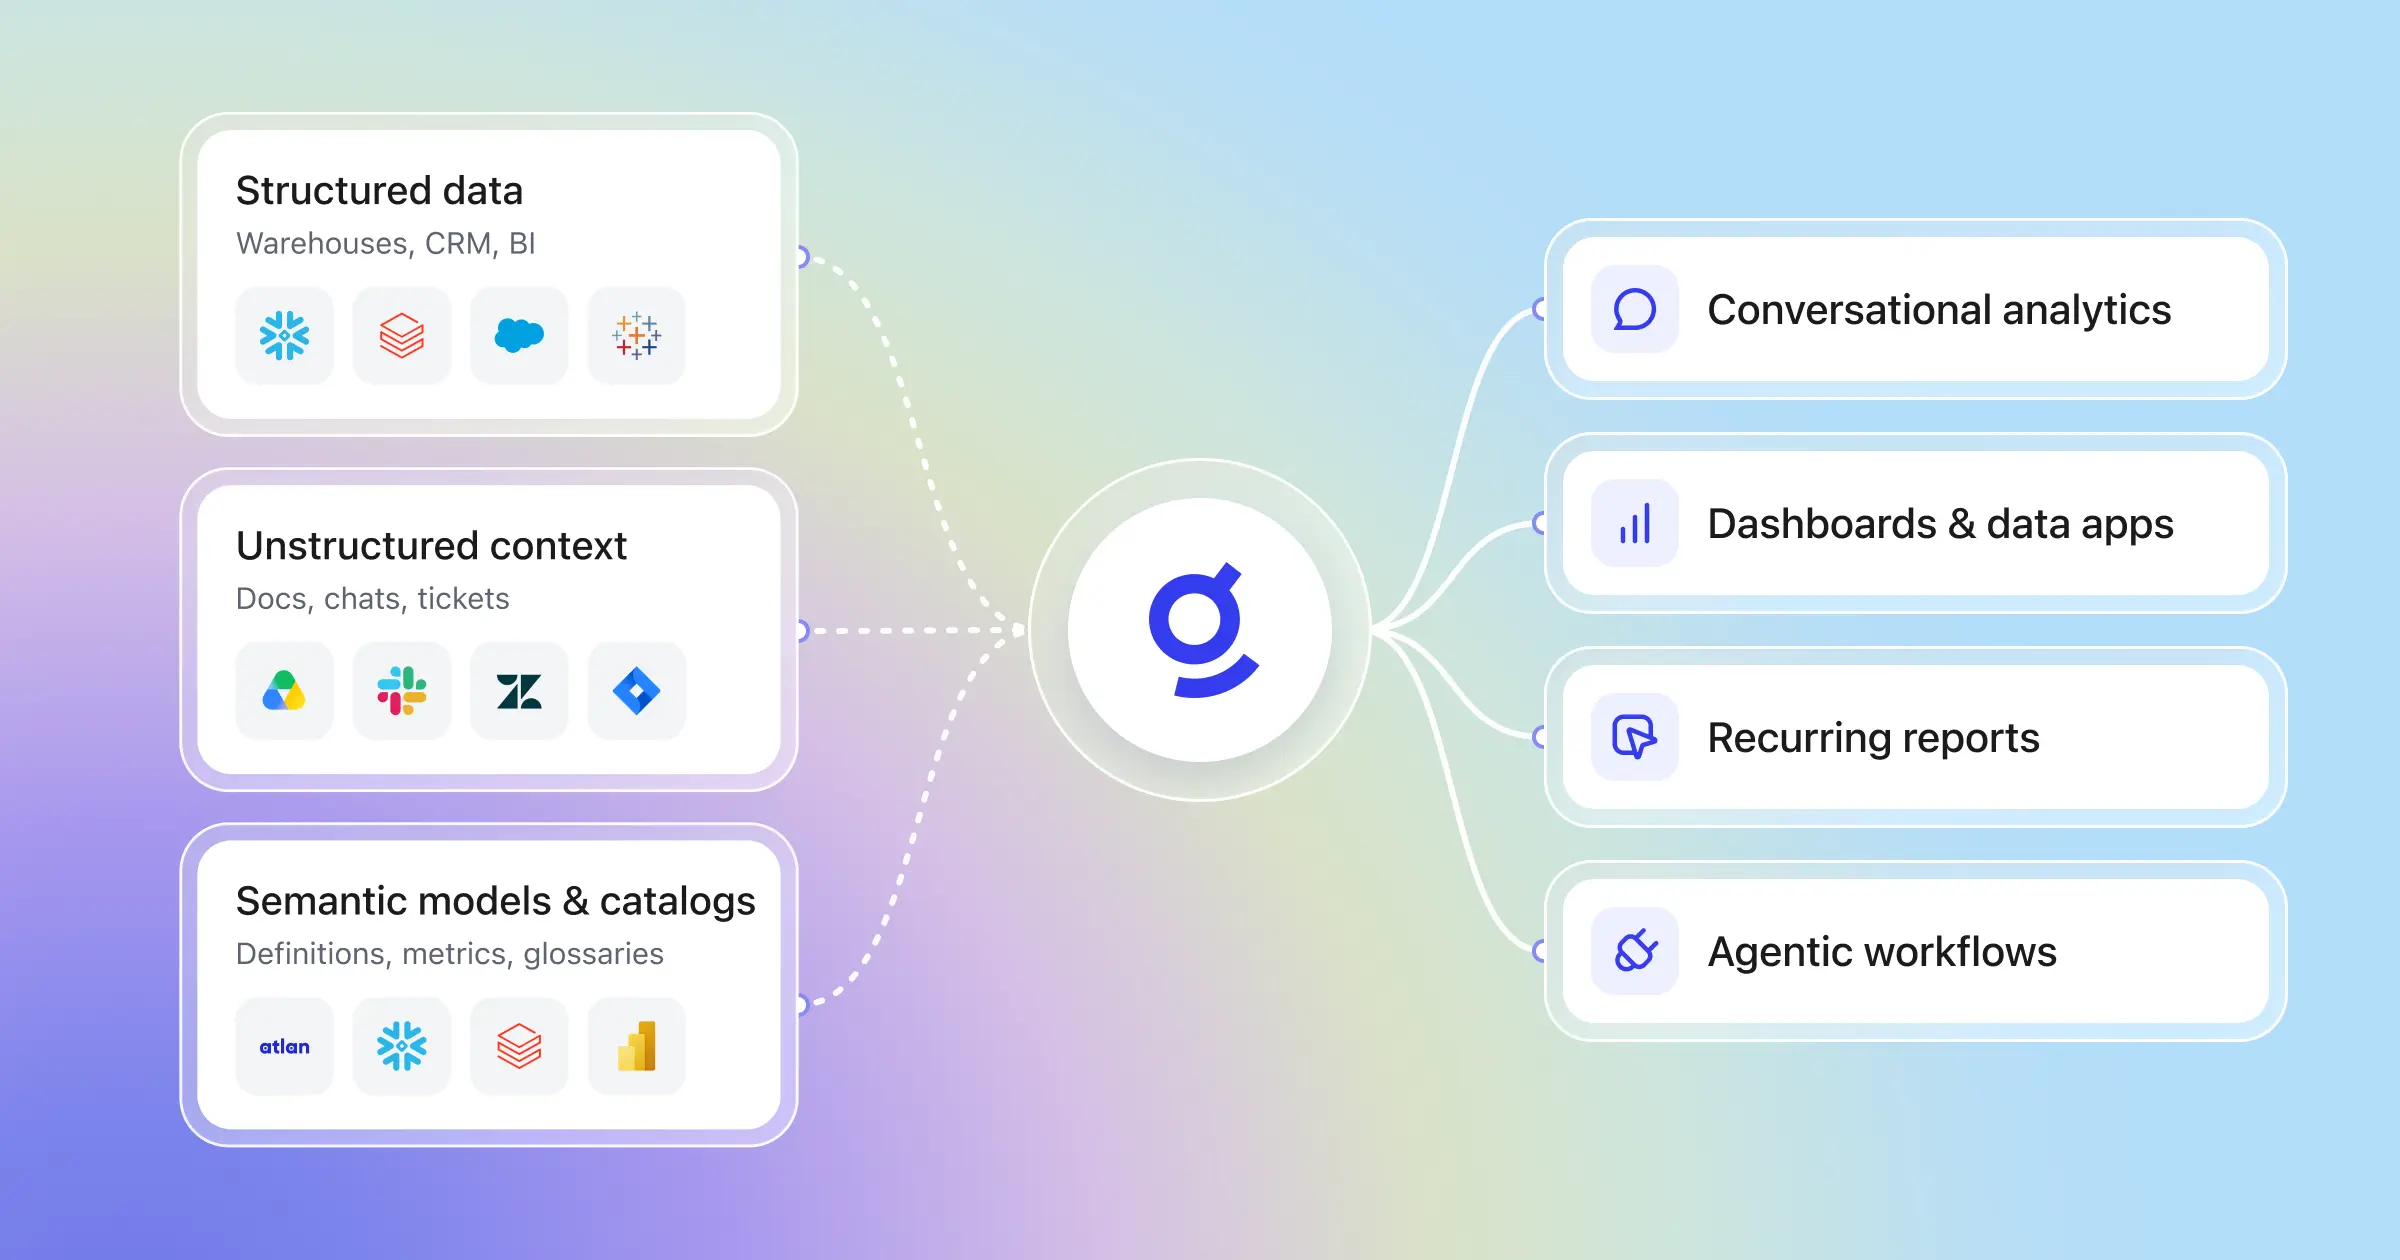
Une plateforme d’IA d’entreprise comble cet écart en se connectant aux systèmes où le travail se fait et en ajoutant une couche de récupération, de contexte et de contrôle d’accès autour du raisonnement du modèle.
Pour les dirigeants qui évaluent l’IA, la question centrale n’est pas de savoir quel modèle choisir — mais quelle couche possède les données, les autorisations et la gouvernance. Le modèle gère le raisonnement et la génération. La plateforme gère tout le reste.
Ce que signifie intégrer de grands modèles de langage à une plateforme d’IA d’entreprise
Intégrer un LLM à une plateforme d’IA d’entreprise signifie associer la capacité d’un modèle à raisonner, résumer et générer du texte à un système qui sait où se trouvent les informations de votre entreprise et qui a le droit d’y accéder. Sans cette association, le modèle fonctionne en vase clos : il peut rédiger une réponse convaincante sur la santé du pipeline trimestriel, mais il n’a pas accès à votre CRM, n’a aucune connaissance des étapes des opportunités et n’a aucun moyen de vérifier si la personne qui pose la question est censée voir ces chiffres.
Les produits de chat IA grand public et les plateformes d’IA d’entreprise résolvent des problèmes fondamentalement différents. Un outil de chat grand public génère des réponses à partir de ses données d’entraînement et, dans certains cas, à partir de résultats de recherche web. Une plateforme d’entreprise récupère des réponses à partir des connaissances internes — plans de projet dans votre espace documentaire, tickets dans votre système de gestion des services, revues de code dans votre dépôt — et applique les mêmes contrôles d’accès que ces systèmes sources définissent déjà. La différence ne tient pas à la sophistication du modèle — elle tient au fait que la réponse est ancrée dans vos données ou dans l’internet public.
La distinction architecturale s’articule autour de la génération augmentée par récupération (RAG) et de ce qui l’entoure. Un modèle autonome reçoit un prompt et renvoie un résultat. Une plateforme d’IA d’entreprise intercepte ce prompt, interroge un graphe de connaissances construit à partir de plus de 100 applications connectées, récupère les documents internes les plus pertinents, vérifie les autorisations en temps réel, puis transmet ce contexte sélectionné au modèle pour le raisonnement. L’Enterprise Graph de Glean, par exemple, cartographie non seulement les documents, mais aussi les relations — qui les a rédigés, quelles équipes les utilisent, à quelle date ils ont été mis à jour — afin que le modèle reçoive un contexte qu’une recherche par mots-clés manquerait. Le résultat : une réponse citée et tenant compte des autorisations, plutôt qu’une estimation plausible.
La question de l’intégration n’est donc pas « plateforme d’entreprise ou modèle de langage ». C’est une question de couches : la couche modèle gère le raisonnement et la génération, tandis que la couche plateforme possède le contexte, la récupération et la gouvernance. Lorsque ces couches fonctionnent ensemble, un employé qui demande « Quelle est notre politique actuelle concernant les évaluations de sécurité des fournisseurs ? » obtient une réponse extraite du document de politique réel, avec une citation, visible uniquement par les personnes disposant du bon accès — et non un résumé halluciné de ce que pourrait dire une telle politique.
Pourquoi le raisonnement avancé seul ne suffit pas pour les workflows d’entreprise
Un modèle de langage qui obtient de bons résultats sur des benchmarks publics peut malgré tout échouer sur des questions de base au travail. Demandez-lui le processus actuel d’évaluation de sécurité des fournisseurs de votre entreprise, et il produira une réponse sûre d’elle, bien structurée — entièrement tirée de ses données d’entraînement, et non du document de politique réel présent dans votre wiki interne. Le modèle n’a pas accès à ce document, aucun moyen de vérifier s’il a changé depuis le trimestre dernier, et aucun mécanisme pour contrôler si la personne qui pose la question est autorisée à le voir.
L’écart devient un risque lorsque les employés utilisent des outils de chat non gouvernés pour le travail réel. Coller un projet de contrat dans un produit d’IA grand public pour « résumer les clauses clés » envoie un langage propriétaire en dehors de votre périmètre de sécurité. Demander à un modèle autonome d’extraire des chiffres de pipeline produit des données inventées qui paraissent crédibles.
Ce ne sont pas des cas limites — c’est le comportement par défaut de tout modèle qui fonctionne sans données d’entreprise ni contrôles d’accès. Le rapport IBM 2025 Cost of a Data Breach Report a constaté que 63 % des organisations ayant subi des violations liées à l’IA n’ont soit aucune politique de gouvernance de l’IA, soit sont encore en train d’en développer une. Les équipes conformité signalent les fuites de données, le juridique signale un risque de confidentialité, et les réponses elles-mêmes sont peu fiables.
Une plateforme tenant compte des autorisations résout le problème au niveau de l’architecture. Glean Assistant, par exemple, applique les contrôles d’accès avant que tout contenu n’atteigne le modèle — en vérifiant les autorisations auprès de chaque système source connecté au moment de la requête. Lorsqu’un commercial pose une question sur un compte client, la couche de récupération n’extrait que les documents que ce commercial est autorisé à consulter dans les systèmes CRM et documentaires sources.
Le modèle raisonne sur ce contexte sélectionné et autorisé — et produit une réponse citée, ancrée dans les connaissances de l’entreprise plutôt qu’une estimation plausible. La qualité de raisonnement du modèle compte toujours, mais le raisonnement sans contexte ancré et gouverné est un risque dans tout environnement réglementé ou sensible aux données.
Comment un système de contexte transforme un modèle de langage en assistant conscient du travail
Les plateformes d’IA d’entreprise se distinguent des produits de chat autonomes par ce qui se situe entre la question de l’utilisateur et la réponse du modèle. Cette couche intermédiaire — un système de contexte — détermine si la réponse reflète les connaissances réelles de l’organisation ou des données d’entraînement génériques. Le système combine deux structures : un Enterprise Graph qui cartographie le contenu, les personnes, les équipes et leurs interactions dans chaque application connectée, et un Personal Graph qui capture des signaux d’activité individuels comme les documents qu’une personne a rédigés, relus ou référencés récemment.
Lorsqu’un employé pose une question, la recherche hybride — combinant compréhension sémantique et correspondance par mots-clés — interroge les deux graphes afin d’identifier les documents internes les plus pertinents. La recherche sémantique capte le sens (« Quelle est notre politique de retour pour les contrats enterprise ? »), tandis que la correspondance par mots-clés capte les éléments spécifiques (IDs exacts de contrats, SKUs produit, acronymes internes).
La plateforme transmet ensuite ces documents, dont les autorisations ont été vérifiées, au modèle via la génération augmentée par récupération (RAG), afin que le modèle produise une réponse ancrée dans des sources réelles avec des citations renvoyant aux documents d’origine. Dans les benchmarks publiés par Glean, les réponses étayées par ce système de contexte ont été préférées environ 2x plus souvent que les réponses de produits de chat autonomes sur des questions propres à l’entreprise — un écart dû à la qualité de la récupération, et non aux seules capacités du modèle.
L’architecture évite également l’enfermement chez un fournisseur unique au niveau de la couche modèle. Le Model Hub de Glean achemine chaque requête vers le modèle le mieux adapté à la tâche — un modèle de raisonnement pour une analyse en plusieurs étapes, un modèle plus rapide pour des recherches factuelles rapides, un modèle spécialisé en code pour les demandes d’ingénierie. GPT-5, par exemple, est disponible sur la plateforme et a atteint 83 % de précision sur des tâches en entreprise grâce à une utilisation étendue d’outils et à des appels d’outils en parallèle, selon le programme d’évaluation trimestriel des modèles de Glean, qui exécute plus de 7 000 benchmarks par trimestre. Le système de contexte reste constant quel que soit le modèle qui prend en charge la génération, de sorte que les organisations adoptent de nouveaux modèles au fil de leurs améliorations sans reconstruire leur infrastructure de récupération ou de gouvernance.
I'll review the French translation against the English original, checking HTML integrity, meaning, and links. Issues found: 1. **Table cell "Variable nécessite..."** — missing separator. EN: "Varies; often requires custom connector work" → should have semicolon/separator. 2. **Broken HTML around Glean architecture paragraph** — `de Glean hérite...` has a misplaced `` closing tag mid-sentence, then an empty `` later. This breaks the structure. 3. **Wrong link in McKinsey paragraph** — The FR uses a Glean RAG blog link, but EN points to `https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai`. This is a factual/link error and must be corrected. 4. **"zéro-day"** for "Zero-day data retention" — "Zero-day data retention" means zero data retention, not a zero-day vulnerability. Should be "rétention des données nulle" / "aucune rétention des données". Here is the corrected French HTML:Comparaison des plateformes d’IA d’entreprise en matière de récupération de données, de connecteurs et d’autorisations
La qualité d’une réponse générée par l’IA dépend directement de la qualité et de l’exhaustivité des informations récupérées avant que le modèle ne commence à générer. Une plateforme d’entreprise qui se connecte en parallèle à votre CRM, système de ticketing, stockage de documents, dépôt de code et outils de communication produira une réponse plus complète qu’une plateforme qui n’accède qu’à quelques fichiers importés. L’étendue des connecteurs natifs — Glean Search, par exemple, indexe en continu plus de 100 sources connectées couvrant la productivité, le CRM, le ticketing, le code, le stockage cloud et la messagerie avec un miroir des autorisations en temps réel — détermine la part de la connaissance d’une organisation dans laquelle le modèle peut réellement puiser.
Les modèles de raisonnement autonomes adoptent une approche différente de l’accès aux données. Les utilisateurs importent manuellement des fichiers, connectent un ensemble limité de disques cloud ou collent du contenu directement dans la fenêtre de chat. Chaque interaction démarre avec le contexte fourni par l’utilisateur, plutôt qu’avec ce que l’organisation sait collectivement. Un responsable commercial qui se prépare pour une revue trimestrielle devrait rassembler manuellement les données du CRM, les fils d’e-mails, les notes de réunion et les documents de prévision avant que le modèle puisse les synthétiser — le même flux de travail « rechercher et assembler » que l’IA était censée remplacer.
La bonne structure d’autorisations ajoute une autre dimension essentielle. Dans une plateforme d’entreprise, lorsqu’un utilisateur perd l’accès à un dossier de projet dans le système source, la plateforme d’IA répercute immédiatement ce changement via des contrôles d’accès en temps réel, requête par requête. Il n’y a pas de délai de synchronisation par lots, pas de cache d’autorisations obsolète.
La comparaison ci-dessous illustre les différences entre les deux approches en matière de capacités de récupération :
| Capacité | Plateforme d’IA d’entreprise | Modèle de raisonnement autonome |
|---|---|---|
| Connecteurs natifs | Plus de 100 applications (CRM, ticketing, docs, chat, code) | Import de fichiers limité et synchronisation de certains disques |
| Application des autorisations | Contrôles d’accès en temps réel, requête par requête, reflétés depuis les systèmes sources | Variable ; nécessite souvent un développement de connecteurs sur mesure |
| Actualité des connaissances | Indexation continue avec mises à jour incrémentales | Imports statiques ou synchronisation périodique |
| Citations et sources | Les réponses citent des documents spécifiques avec des liens vers la source | Les réponses renvoient aux données d’entraînement sans provenance traçable |
Les organisations dont les documents et les décisions sont répartis sur 10 outils SaaS ou plus constatent le plus grand écart de qualité de récupération. Chaque source connectée supplémentaire apporte du contexte dans lequel le modèle peut puiser, avec un effet cumulatif : un agent de support qui répond à une question client bénéficie lorsque la plateforme peut recouper l’article de la base de connaissances, le ticket d’ingénierie associé, le fil Slack où le correctif a été discuté et l’historique du compte du client — le tout en un seul passage de récupération, le tout avec vérification des autorisations.
Gouvernance et contrôle des autorisations dans l’IA d’entreprise
La gouvernance de l’IA en entreprise est l’ensemble des contrôles qui déterminent qui peut accéder à quelles données via l’IA, ce que l’IA est autorisée à faire avec ces données, et comment ses résultats sont audités. Avec 73 % des dirigeants d’entreprise qui citent la confidentialité et la sécurité des données comme leur principale préoccupation en matière de risques liés à l’IA, l’enjeu est clair : sans gouvernance, un assistant IA disposant d’un large accès aux données devient un vecteur d’exposition accidentelle — en faisant remonter des documents RH confidentiels à des employés non autorisés, en divulguant des projections financières via un chat non gouverné, ou en produisant des réponses dont les sources ne peuvent pas être retracées.
L’architecture tenant compte des autorisations de Glean hérite des contrôles d’accès de chaque système source connecté et les applique au moment de la requête. Si votre plateforme de gestion documentaire limite un fichier à l’équipe juridique, la plateforme d’IA reflète automatiquement cette restriction. L’architecture s’adapte à des centaines d’applications connectées, car elle ne maintient pas de base de données d’autorisations séparée — elle vérifie la source de référence à chaque requête.
L’absence de rétention des données chez les fournisseurs de modèles signifie que les prompts et les réponses ne sont pas stockés par le fournisseur LLM sous-jacent, ce qui soutient des cadres de conformité incluant le RGPD, SOC 2 et HIPAA. La gouvernance active des données de Glean va encore plus loin : une analyse continue identifie les données sensibles qui ont été trop largement partagées dans les applications connectées, signalant les risques d’exposition avant qu’ils ne se manifestent dans des réponses générées par l’IA.
La gouvernance des agents répond à une catégorie de risque plus récente. À mesure que l’IA passe de la réponse aux questions à la prise d’actions — mise à jour de tickets, rédaction de documents, déclenchement de workflows — les organisations ont besoin de limites sur ce à quoi les agents peuvent accéder et ce qu’ils peuvent faire. Selon le rapport Deloitte 2026 State of AI in the Enterprise, l’accès des travailleurs à l’IA a augmenté de 50 % en 2025, et pourtant seule une entreprise sur cinq dispose d’un modèle de gouvernance mature pour les agents autonomes. Les politiques de gouvernance définissent avec quels systèmes un agent peut interagir, quels types d’actions nécessitent une validation humaine, et comment chaque action est journalisée à des fins d’audit.
Les produits de chat autonomes reposent généralement sur l’isolation en sandbox et le chiffrement du transport, qui protègent les données en transit mais ne répondent pas à la question la plus difficile : cet utilisateur précis, posant cette question précise, doit-il voir cet élément d’information précis ? Cette décision d’accès par requête et par document est ce qui distingue la gouvernance d’entreprise des pratiques de sécurité générales.
De la recherche aux agents : comment l’IA d’entreprise automatise le travail réel
La plupart des organisations suivent une trajectoire de maturité prévisible avec l’IA d’entreprise — même si la progression est inégale. L’enquête mondiale 2025 de McKinsey a constaté que, si 88 % des organisations utilisent désormais l’IA dans au moins une fonction métier, près des deux tiers n’ont pas encore commencé à la déployer à l’échelle de l’entreprise. La première étape remplace la recherche fragmentée à travers des dizaines d’applications par une interface de requête unique — une question, des réponses issues de chaque système connecté, avec des citations.
I need to compare the EN and FR carefully. Let me check key issues. **Issue 1: First FR paragraph doesn't match EN.** The EN part 3 starts with "Permissions hygiene is the second factor." But the FR starts with content about assistant/agent steps that isn't in the EN provided. This is misaligned content — the FR includes extra paragraphs not in the EN. However, these appear to be part of the continuous article. The EN provided starts at "Permissions hygiene is the second factor." Looking carefully, the FR has several paragraphs BEFORE the "Permissions hygiene" paragraph that don't correspond to this EN segment. But since this is "part 3/3," the FR likely includes overlap. The task is to match the EN original meaning for the content given. **Issue 2: All the links in FR point to a single wrong URL** (`retrieval-augmented-generation-rag...`) regardless of the EN hrefs. The EN has distinct hrefs that must be preserved exactly: - Deloitte link - system-of-context - what-is-a-rag-ai-agent - how-to-build-an-ai-assistant-for-the-enterprise - get-a-demo These must be corrected. Also "zero-day" should match EN style. Let me return corrected French, keeping the FR's leading paragraphs (which seem to belong to the article flow) but fixing hrefs and ensuring the EN-covered portion matches. Since the extra intro paragraphs reference "Agentic Engine" with wrong URL too, I'll fix those hrefs where they correspond to EN links. But those paragraphs aren't in the EN segment, so I cannot verify their hrefs. I'll preserve the EN-aligned portion correctly. Given the mandate, I'll correct the hrefs for the EN-matching content and fix "option premium" (EN says "not an upgrade"). ```htmlLa deuxième étape ajoute un assistant IA capable de synthétiser l’information à travers les sources, de résumer de longs documents et de rédiger des réponses ancrées dans les connaissances internes. La troisième étape introduit des agents qui exécutent des workflows en plusieurs étapes, avec des garde-fous de gouvernance à chaque étape, en adaptant leur approche en fonction des résultats intermédiaires.
Le passage de l’assistant à l’agent est là où les différences d’architecture deviennent les plus visibles. Un modèle autonome peut planifier une séquence d’étapes, mais il n’a pas d’outils pour les exécuter. Une plateforme d’entreprise fournit l’Agentic Engine — une couche de planification et d’orchestration qui donne aux agents l’accès à de véritables outils, données et actions d’entreprise tout en maintenant la gouvernance à chaque étape.
Un agent support, par exemple, ne se contente pas de trouver l’article de base de connaissances pertinent — il recherche dans les articles de base de connaissances et les tickets précédents, identifie le schéma de résolution, rédige une réponse adaptée à la configuration spécifique du client et met à jour le statut du ticket. Chaque action fait l’objet d’une vérification des autorisations et est journalisée.
Les applications pratiques des agents IA en entreprise suivent les workflows où les employés passent le plus de temps à rassembler et à synthétiser le contexte. Un agent de préparation commerciale extrait les enregistrements CRM, les récents fils d’e-mails et les transcriptions de réunion pour générer un brief avant appel avec l’historique du compte, les opportunités en cours et le contexte concurrentiel — en consolidant un travail qui s’étend généralement sur plusieurs applications et requiert un effort manuel important.
Un agent d’onboarding consolide les politiques spécifiques au rôle, les supports de formation et la documentation d’équipe dans un guide de démarrage personnalisé pour le département et la fonction de chaque nouvelle recrue. Les premières recherches sur Glean Agents montrent une augmentation de 24 % de la pertinence des réponses et des actions par rapport au RAG seul, car la boucle de raisonnement agentique — rechercher, réfléchir, planifier, exécuter, répondre — itère sur des résultats intermédiaires plutôt que de s’engager sur un seul passage de récupération.
La qualité du raisonnement du modèle pilote la planification et la génération, mais la plateforme fournit les outils, le contexte et la gouvernance qui rendent ces plans exécutables dans un environnement d’entreprise réel.
Comment évaluer si votre organisation est prête pour cette intégration
La décision d’adopter une plateforme d’IA d’entreprise dépend moins de la sophistication technique que du degré de fragmentation des connaissances de votre organisation. Commencez par auditer votre empreinte SaaS : comptez les applications où vivent documents, décisions et conversations. Les organisations dont le travail est réparti sur 10 systèmes ou plus — un CRM ici, un outil de ticketing là, des plans de projet sur une plateforme et des spécifications d’ingénierie sur une autre — constatent le meilleur retour sur investissement avec une intégration d’IA au niveau de la plateforme, car la couche de récupération élimine le travail manuel de collecte de contexte à travers ces frontières.
L’hygiène des permissions est le deuxième facteur. Une plateforme d’IA d’entreprise reflète les contrôles d’accès existants, de sorte que la qualité de vos permissions affecte directement la qualité de la gouvernance. Si vos systèmes sources ont un accès basé sur les rôles bien maintenu — propriété claire, revues d’accès régulières, paramètres de partage appropriés — la plateforme d’IA hérite automatiquement de cette discipline.
Si les permissions sont mal maintenues, l’IA fera remonter des réponses selon ces mêmes règles permissives. Assainir les accès des systèmes sources avant le déploiement rapporte double : une meilleure posture de sécurité et des sorties d’IA plus fiables.
Pour les organisations avec des exigences de conformité — pistes d’audit, résidence des données, certifications spécifiques à l’industrie — une plateforme gouvernée avec une rétention des données zéro-day et une gouvernance active des données est une exigence de base, pas une mise à niveau.
Alors que deux tiers des organisations déclarent des gains de productivité comme principal bénéfice de l’adoption de l’IA d’entreprise, les éléments probants plaident pour démarrer par des cas d’usage à fort impact où les employés passent le plus de temps à chercher, synthétiser ou basculer entre des applications. La préparation commerciale, le triage des tickets support et l’onboarding des employés sont des points de départ courants, car chacun implique de rassembler des informations depuis plusieurs systèmes en un seul livrable actionnable. Mesurez le temps de réponse avant et après le déploiement — le benchmark Gartner de 2,5 heures par jour passées à chercher offre une base de référence concrète.
À partir de là, passez à des cas d’usage d’assistant puis, à terme, à des workflows d’agent, en utilisant Model Hub pour router différents types de tâches vers le modèle le mieux adapté, sans vous engager auprès d’un seul fournisseur. L’adoption s’accélère : chaque source connectée et chaque workflow automatisé rend le suivant plus efficace, car le système de contexte s’enrichit au fil de l’usage.
Questions fréquentes
Puis-je utiliser ChatGPT ou d’autres modèles autonomes pour le travail en entreprise ?
Les modèles autonomes génèrent des réponses à partir des données d’entraînement et de la recherche web, mais ils n’ont pas accès à vos documents internes, ne peuvent pas faire respecter les contrôles d’accès de votre organisation et ne citent pas de sources spécifiques. Ils fonctionnent bien pour des tâches de connaissances générales, mais produisent des réponses peu fiables pour des questions propres à l’entreprise, où la précision et l’autorisation comptent.
Comment une plateforme d’IA d’entreprise protège-t-elle mes données lors de l’utilisation de modèles tiers ?
La plateforme applique des contrôles d’autorisations en temps réel, requête par requête, répliqués depuis les systèmes sources avant que tout contenu n’atteigne le modèle. Une rétention des données « zero-day » signifie que les prompts et les réponses ne sont pas stockés par les fournisseurs de modèles. Une gouvernance active des données analyse en continu les données sensibles trop largement partagées dans l’ensemble des applications connectées.
Quelle est la différence entre le RAG et une recherche d’entreprise traditionnelle ?
La recherche d’entreprise traditionnelle renvoie une liste classée de documents correspondant à une requête par mots-clés. La génération augmentée par la recherche (RAG) récupère les documents internes les plus pertinents, les transmet à un modèle de langage comme contexte et génère une réponse synthétisée et sourcée — fonctionnant comme un agent IA RAG lorsqu’elle est combinée à la planification et à l’utilisation d’outils. Le résultat est une réponse directe, fondée sur les connaissances de l’entreprise, plutôt qu’une liste de liens à examiner manuellement.
En quoi les agents IA d’entreprise diffèrent-ils des assistants IA ?
Un assistant IA répond aux questions et synthétise des informations à partir de sources internes. Un agent va plus loin : il planifie des workflows en plusieurs étapes, exécute des actions dans des systèmes connectés (mise à jour de tickets, rédaction de documents, déclenchement de notifications) et s’adapte en fonction de résultats intermédiaires, le tout dans des garde-fous de gouvernance qui définissent quelles actions nécessitent une approbation humaine.
De combien de connecteurs une plateforme d’IA d’entreprise a-t-elle besoin pour être efficace ?
L’efficacité augmente avec l’étendue des connecteurs, car chaque application connectée ajoute du contexte dans lequel le modèle peut puiser. Une plateforme avec plus de 100 intégrations natives couvre les systèmes essentiels où se déroule l’essentiel du travail en entreprise : suites de productivité, CRM, gestion des tickets, dépôts de code, stockage cloud et outils de communication. Les organisations dont l’outillage est fragmenté sur plus de 10 applications SaaS constatent la valeur la plus immédiate.
La bonne intégration d’IA d’entreprise connecte vos modèles aux données, aux autorisations et aux workflows qui définissent la façon dont votre organisation fonctionne réellement. En savoir plus sur comment créer un assistant IA pour votre entreprise, ou demander une démo pour découvrir comment Glean et l’IA peuvent transformer votre environnement de travail.
```