Avant de signer un contrat, posez trois questions que la plupart des éditeurs préféreraient éviter : où mes données sont-elles stockées ? Une partie est-elle utilisée pour entraîner des modèles ? Combien de temps sont-elles conservées après la génération ? Les réponses distinguent les outils qui considèrent la sécurité comme un principe de conception de ceux qui l’ont ajoutée après qu’une équipe achats l’a demandé. Pour les organisations qui déploient des agents IA à grande échelle, une gouvernance active des données qui signale et corrige les données sensibles partagées par accident devient une exigence de base.
Note: The rest of the translation is accurate and all other HTML tags/hrefs are preserved correctly. The single correction needed is replacing the incorrect `fourdots.com` URL with the correct Glean data governance URL (localized to `/fr/`) for the "gouvernance active des données" link. I'll review this translation carefully against the English original, checking meaning, HTML tags, and links. Notable issues found: 1. **Links**: The EN original has a specific link `https://www.glean.com/blog/knowledge-graph-agentic-engine` for "knowledge graphs" and `https://hai.stanford.edu/ai-index/2026-ai-index-report/responsible-ai` for the Stanford report. The FR translation replaced BOTH with `https://fourdots.com/business-impact-of-ai-hallucinations-rates-and-ranks`. These hrefs must match the EN original. 2. The FR text begins mid-content (part 2/3) with a connectors section not shown in EN — this appears to be continuation content; I'll preserve it but fix the links within it where they correspond to EN. Here is the corrected French HTML:Recherchez des connecteurs natifs vers les plateformes que votre équipe utilise déjà au quotidien : votre CMS, CRM, outil de gestion de projet et applications de messagerie. Un rédacteur capable de générer un premier jet dans son CMS supprime entièrement l’étape de copier-coller, et un responsable sales enablement capable d’intégrer des messages approuvés directement dans un pitch deck depuis son navigateur élimine un aller-retour vers la bibliothèque de contenus. Tous les connecteurs enterprise ne se valent pas — posez aux éditeurs neuf questions critiques pour distinguer les véritables systèmes d’IA enterprise de ceux qui s’appuient sur des intégrations tierces superficielles.
Ici, les intégrations préconfigurées l’emportent sur la simple disponibilité d’API — la plupart des équipes contenu n’ont pas les ressources d’ingénierie nécessaires pour créer et maintenir des connexions sur mesure. L’extension navigateur de Glean et son intégration Slack, par exemple, permettent aux équipes contenu de générer et d’affiner des brouillons sans quitter les applications qu’elles ont déjà ouvertes.
Évaluez la façon dont l’outil gère le contexte multi-sources
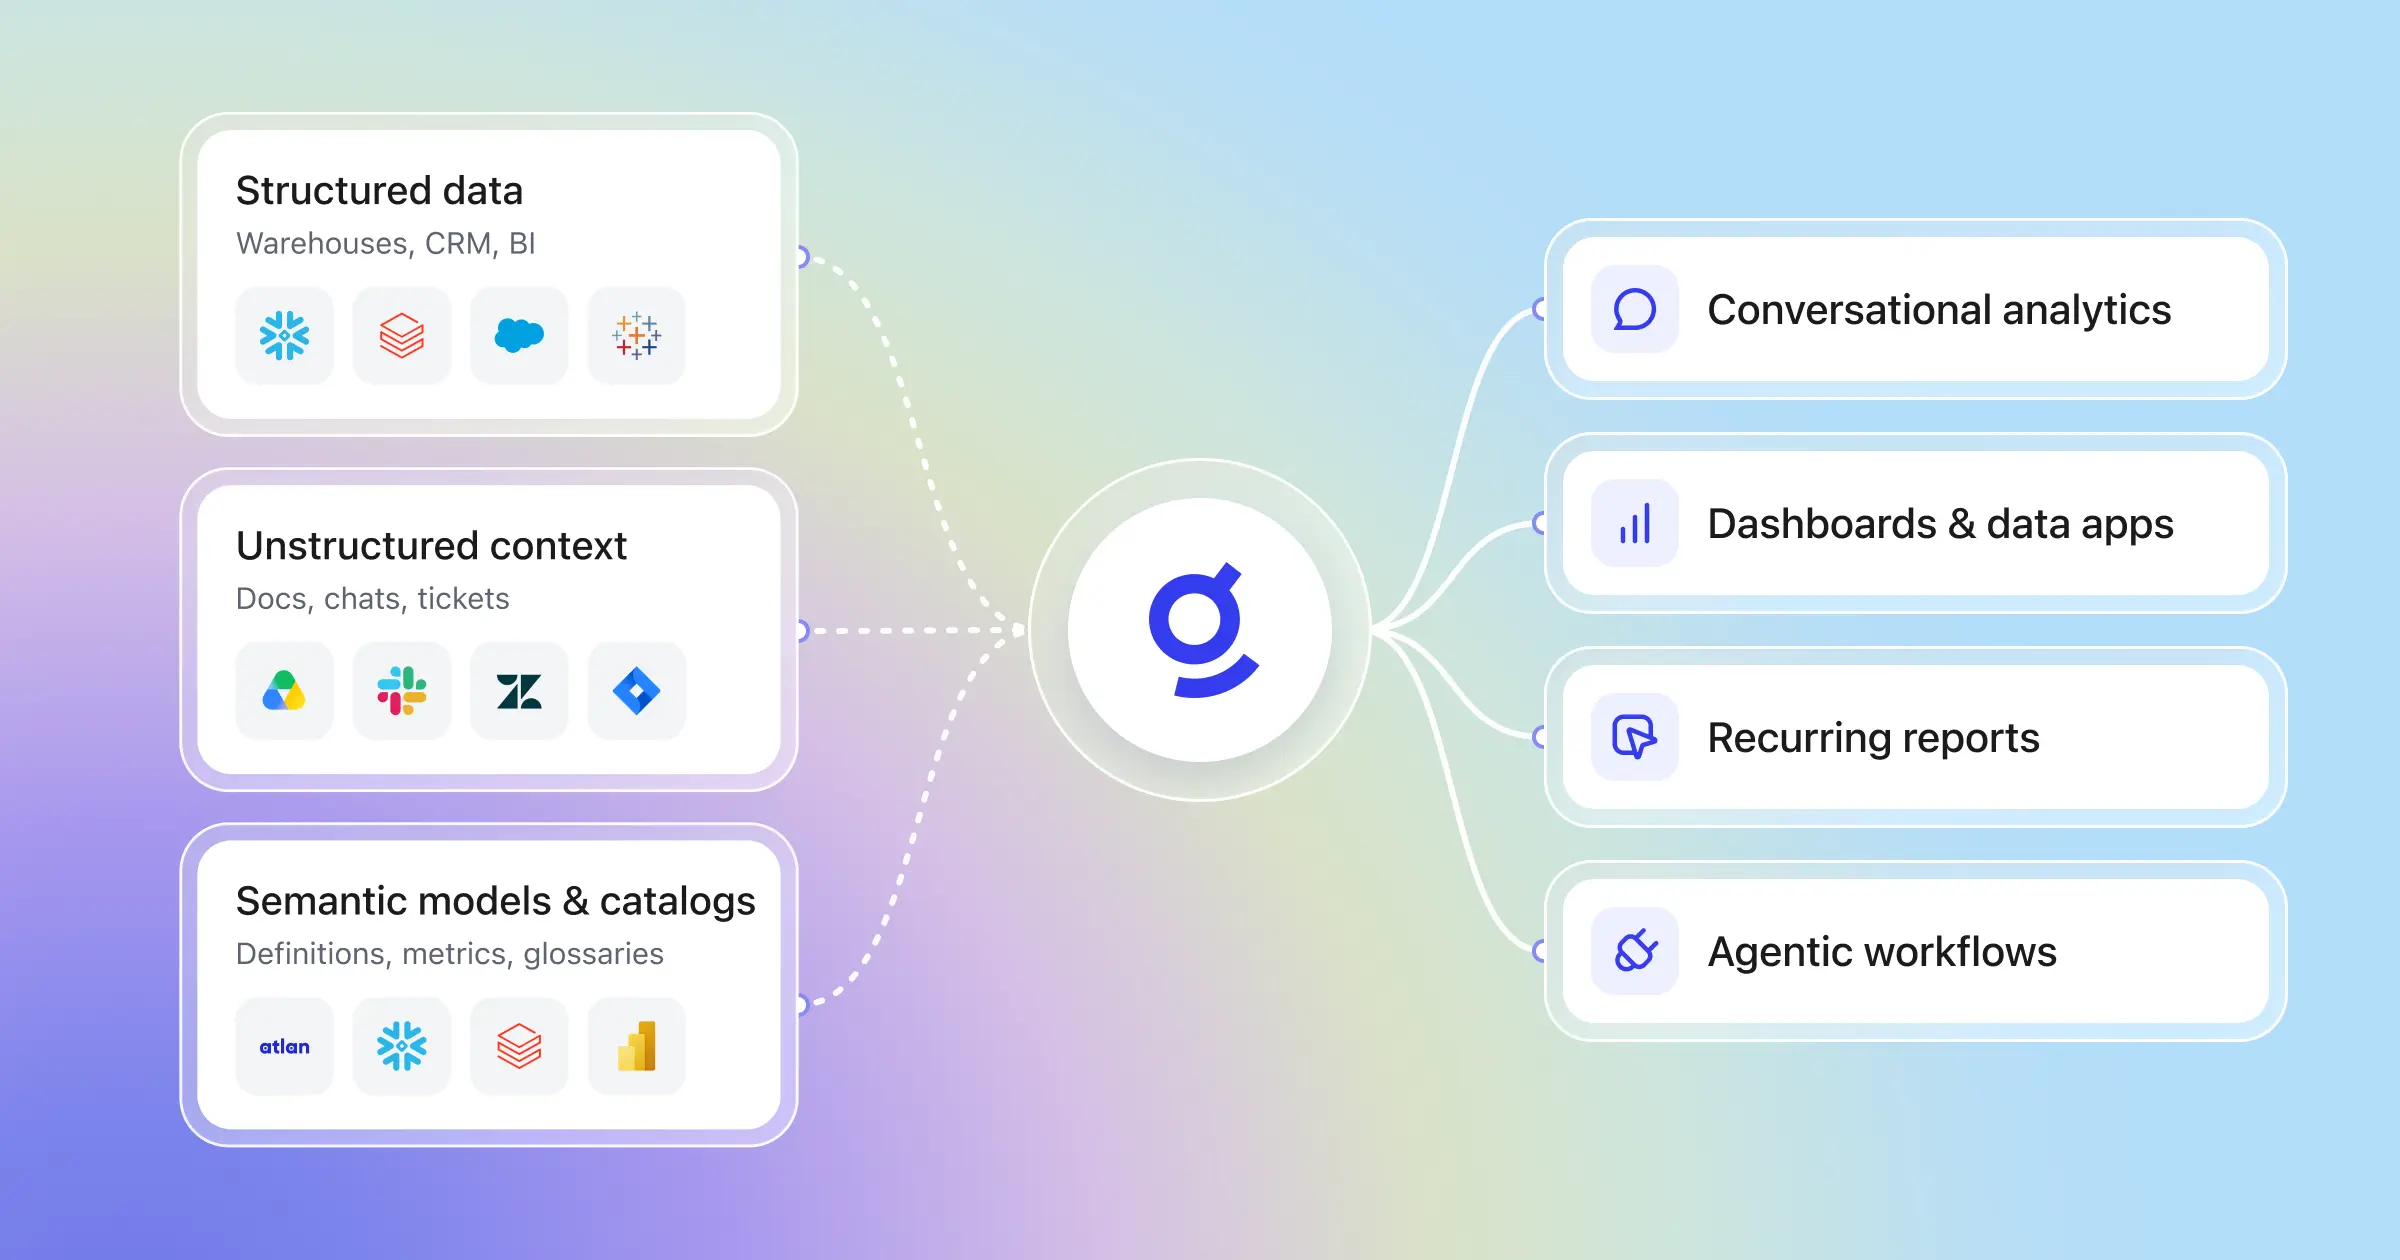
Un contenu fidèle à la marque ne s’appuie que rarement sur un seul référentiel. Un article de lancement de produit peut nécessiter le positionnement issu d’un document de stratégie, des preuves tirées d’une étude de cas et une terminologie validée provenant d’un guide de style — le tout stocké dans des systèmes différents. L’outil doit pouvoir s’appuyer sur plusieurs sources connectées au sein d’une seule requête de génération, plutôt que de vous obliger à coller manuellement le contexte de chacune. Une étude Forrester a révélé que les entreprises dotées de systèmes intégrés ont atteint un retour sur investissement de 345% sur trois ans, ce qui souligne à quel point la qualité des intégrations impacte le ROI en profondeur. Testez ce point pendant l’évaluation en utilisant un brief réel qui nécessite des informations provenant d’au moins trois plateformes différentes. Si l’outil ne peut pas synthétiser des informations issues de plusieurs sources, votre équipe passera autant de temps à rassembler les inputs qu’elle n’en gagnera sur la rédaction.
Ce que la personnalisation de contenu exige réellement à l’échelle enterprise
Dans la plupart des outils d’IA pour le contenu, la personnalisation consiste à remplacer un prénom dans un modèle. C’est du publipostage, pas de la personnalisation. La vraie personnalisation adapte le ton, le niveau de technicité, les preuves et les cas d’usage en fonction de la cible du contenu, du canal de diffusion et de l’étape du lecteur dans son parcours d’achat. Une analyse technique approfondie destinée à une équipe platform engineering ne ressemble en rien à un résumé exécutif pour un CFO — même si les deux portent sur le même produit.
Deux couches de contexte distinctes rendent cela possible. La première est le contexte organisationnel : les lignes directrices de la voix de votre marque, les frameworks de messages validés, le positionnement produit et la différenciation concurrentielle. Cette couche reste relativement stable et s’applique à l’ensemble des contenus.
La seconde couche est le contexte personnel — qui crée le contenu, sur quel projet la personne travaille et quel segment d’audience elle cible. Un field marketer qui crée un one-pager pour des prospects du secteur de la santé a besoin d’exemples différents d’un partner marketer qui écrit pour un revendeur technologique. L’outil doit reconnaître cette différence sans exiger un nouveau prompt à chaque fois.
Sans ces deux couches fonctionnant ensemble, la personnalisation reste manuelle. Les rédacteurs finissent par maintenir une table de correspondance mentale du type « pour cette audience, utilisez ces arguments » et par réécrire la sortie de l’IA pour qu’elle corresponde.
Les outils qui valent la peine d’être évalués apprennent des schémas d’interaction au fil du temps — en mettant en avant le contexte dont un utilisateur spécifique a le plus souvent besoin et en l’appliquant sans qu’on le lui demande. Sur le plan architectural, la prise en charge des deux couches de contexte nécessite quelque chose comme l’Enterprise Graph et le Personal Graph de Glean qui fonctionnent ensemble : l’un cartographie les connaissances de l’organisation via des knowledge graphs, l’autre cartographie les habitudes de travail et les préférences de chaque utilisateur.
Comment mesurer si le contenu généré par l’IA est réellement on-brand
« On-brand » fait partie de ces termes que tout le monde utilise sans que personne ne le définisse de la même manière. Sans critères mesurables, la revue de marque devient subjective — un relecteur signale des problèmes de ton, un autre laisse passer exactement le même brouillon, et l’équipe perd confiance à la fois dans l’outil et dans le processus de validation.
Définissez des dimensions de qualité avant d’évaluer les outils
Commencez par décomposer « on-brand » en dimensions spécifiques, notables :
- Cohérence de la voix — le brouillon correspond-il à vos directives documentées sur le ton et la persona ?
- Exactitude factuelle — les affirmations peuvent-elles être reliées à des sources approuvées plutôt qu’à des hallucinations du modèle ?
- Citation des sources — les statistiques, citations de clients et données de performance renvoient-elles à des supports réels et à jour ?
- Alignement des messages — le positionnement produit et les propositions de valeur correspondent-ils à la stratégie go-to-market actuelle ?
- Pertinence du ton — le contenu est-il calibré pour son format et son audience cibles ?
Notez chaque dimension sur une échelle simple — validé, nécessite des retouches mineures, nécessite une révision majeure — et vous remplacez une revue au ressenti par quelque chose de reproductible.
Mettez en place des boucles de feedback entre la sortie de l’IA et les parties prenantes de la marque
La métrique la plus importante n’est pas un score de qualité pris isolément. C’est le taux de validation éditoriale : à quelle fréquence le contenu généré par l’IA passe-t-il la revue sans révision majeure ? Suivez-le dans le temps. Le Stanford AI Index Report 2026 met en lumière un écart connexe : alors que les benchmarks de capacités des IA sont largement publiés, les benchmarks d’IA responsable — y compris la qualité et la sécurité des contenus — accusent du retard, ce qui rend la mesure standardisée d’autant plus importante pour chaque organisation.
Si le taux s’améliore, l’outil apprend de vos corrections. S’il stagne ou baisse, quelque chose a changé — peut-être que votre messaging a évolué après un lancement produit, ou que l’outil a commencé à s’appuyer sur des documents sources obsolètes. Les outils qui fournissent des sorties avec citations rendent l’audit simple, car les relecteurs peuvent vérifier les affirmations sans deviner d’où viennent les informations. Glean Assistant, par exemple, inclut des citations de sources dans chaque réponse — chaque affirmation générée renvoie au document interne précis dont elle provient, afin que les relecteurs puissent vérifier l’exactitude en quelques secondes plutôt qu’en quelques minutes. Mettez en place un audit mensuel au cours duquel les parties prenantes de la marque passent en revue un échantillon aléatoire de contenus publiés générés par l’IA, à l’aide de vos dimensions de qualité. Les dérives sont plus faciles à corriger quand vous les détectez tôt.
Comment construire un cadre d’évaluation pour votre équipe
La plupart des équipes évaluent les outils d’IA de contenu en comparant des listes de fonctionnalités sur les sites web des éditeurs. Cette approche vous dit ce que l’outil peut faire en théorie. Elle ne vous dit rien sur le fait que votre équipe l’utilisera réellement ou s’il produira du contenu publiable à partir des sources de votre marque.
Partez du workflow, pas de la liste de fonctionnalités
Cartographiez votre workflow de production de contenu, du brief à la publication. Identifiez où le temps disparaît : attendre les retours d’experts métier, réécrire des brouillons qui ne respectaient pas le brief, rechercher le dernier messaging approuvé, reformater entre plusieurs outils. Ces goulots d’étranglement constituent vos critères d’évaluation. Un outil qui élimine votre plus gros goulot d’étranglement vaut plus qu’un autre qui a deux fois plus de fonctionnalités mais ne traite pas là où votre équipe bloque réellement. Par exemple, si votre équipe passe trois heures par article à traquer les statistiques produit à jour dans Confluence, Google Drive et Notion, la capacité à interroger les trois en une seule requête compte davantage qu’un éditeur de prompts sophistiqué.
Menez une évaluation réelle avec de vrais utilisateurs
I found critical issues. Let me check them: 1. **First paragraph mismatch**: The EN part 3 begins with "When you apply this rubric..." but the FR starts with a completely different paragraph (about giving 3-5 content creators a brief), plus an entire table that doesn't exist in the EN. This appears to be leftover content from part 2 that doesn't belong here. 2. **Wrong hrefs**: Two links have been changed to `https://fourdots.com/...` instead of the correct Glean URLs. Since the EN original for this part begins at "When you apply this rubric...", the FR must match. The extra paragraph/heading/table at the start don't correspond to the provided EN. However, since I must match the EN original meaning and preserve structure, I'll return the corrected French matching the EN, with correct hrefs.Quand vous appliquez cette grille à une évaluation réelle, les outils qui obtiennent les meilleurs scores gèrent l’ancrage sur la connaissance, les permissions et la gouvernance de marque au niveau de la plateforme. Glean Search obtient de bons résultats sur l’ancrage sur la connaissance et l’application des permissions, car son architecture RAG récupère des informations depuis plus de 100 applications connectées tout en respectant les contrôles d’accès au niveau du document. Pour aller plus loin sur la façon dont les outils d’IA transforment les workflows de création de contenu, commencez par voir comment chaque outil se positionne par rapport aux critères ci-dessus.
Questions fréquentes
Quelles sont les fonctionnalités clés à rechercher dans les outils d’IA pour la génération de contenu ?
Donnez la priorité à l’ancrage sur la connaissance via le RAG, à une sécurité tenant compte des permissions qui reflète votre fournisseur d’identité, à des intégrations natives avec votre stack de contenu existante, ainsi qu’à la capacité d’ingérer la tonalité de votre marque et vos guidelines de style. Le nombre de fonctionnalités compte moins que la capacité de l’outil à traiter les goulots d’étranglement spécifiques de votre workflow de contenu.
Comment garantir la cohérence de marque lors de l’utilisation de l’IA pour le contenu ?
Fournissez à l’outil votre guide de tonalité de marque, vos frameworks de messaging et vos règles de style comme documents sources — pas comme des instructions de prompt qui sont oubliées entre les sessions. Ensuite, mesurez la cohérence en suivant les taux de validation éditoriale dans le temps et en auditant chaque mois un échantillon aléatoire de rendus selon des dimensions de qualité définies.
Quelles métriques utiliser pour évaluer le contenu généré par l’IA ?
Suivez le taux de validation éditoriale (pourcentage de brouillons qui passent la revue sans révision majeure), l’exactitude factuelle (pourcentage d’affirmations traçables jusqu’à des sources approuvées) et le time-to-publishable-draft. Ensemble, ces trois métriques montrent si l’outil produit du contenu exploitable, si ce contenu est fiable et s’il fait réellement gagner du temps à votre équipe.
Comment les outils d’IA peuvent-ils scaler la production de contenu sans perdre en qualité ?
Le passage à l’échelle fonctionne lorsque l’outil s’appuie sur une source unique de vérité pour les guidelines de marque, le positionnement produit et les preuves approuvées — afin que le 50e contenu fasse référence aux mêmes informations exactes que le premier. Sans ancrage centralisé sur la connaissance, la qualité se dégrade à mesure que le volume augmente, car les rédacteurs prennent des raccourcis et la connaissance institutionnelle se dilue.
Quels sont les écueils courants lors du choix d’outils d’IA pour le branding ?
Les trois erreurs les plus fréquentes : évaluer les outils sur la base des résultats d’une démo plutôt que sur ceux issus de vos propres sources de marque, choisir un outil qui exige des compétences en prompt engineering que votre équipe contenu n’a pas, et repousser l’examen de sécurité après la signature du contrat. Lancez un pilote avec de vrais briefs, de vrais utilisateurs et de vraies directives de marque avant de vous engager.
Les outils d’IA qui produisent du contenu conforme à la marque à grande échelle s’appuient sur les connaissances réelles de votre entreprise — et non sur des données d’entraînement publiques. Évaluer ces capacités avant de vous engager évite à votre équipe le scénario le plus coûteux : un outil qui génère du volume mais pas de qualité. Demandez une démo pour découvrir comment Glean et l’IA peuvent transformer votre environnement de travail.